Edge AI o cloud AI nel manifatturiero: latenza, banda e costi reali

Indice dei contenuti
Qual è la vera differenza tra edge AI e cloud AI?
Il punto in cui viene eseguita l'inferenza. L'edge AI esegue il modello su hardware installato sulla macchina o nelle sue immediate vicinanze: un Box PC nel quadro, un Panel PC a bordo linea. Il cloud AI invia i dati a un data center remoto e ne restituisce la risposta. Il settore vota con il proprio budget: IDC colloca la spesa mondiale per l'edge computing a quasi 261 miliardi di dollari nel 2025, diretta verso 380 miliardi entro il 2028, con i carichi di lavoro AI tra i fattori di crescita più rapidi (IDC, mar 2025).
Nessuna delle due soluzioni vince su tutto. La decisione si riduce a tre elementi misurabili: latenza, larghezza di banda e quanto costano una risposta sbagliata o un collegamento che cade.
Quanto è davvero lontano il cloud?
Microsoft pubblica i tempi di andata e ritorno misurati tra le proprie region e la geografia parla chiaro. Da Central India, un andata e ritorno verso South India richiede circa 20 ms e verso Jio India West circa 29 ms, ma West Europe dista circa 140 ms ed East US circa 198 ms (statistiche di latenza di rete Azure, 2026). E si tratta di collegamenti da data center a data center sulla dorsale di Microsoft, prima di aggiungere il collegamento di ultimo miglio dello stabilimento, l'overhead della VPN e il tempo di coda dell'inferenza.
Un controllo di visione che comanda un braccio di scarto a 60 pezzi al minuto dispone di una finestra decisionale di un secondo: spenderne 200 ms in un andata e ritorno di rete, il doppio considerando l'elaborazione, resta praticabile finché il collegamento non presenta jitter. Un interblocco di sicurezza o un anello di controllo chiuso non possono dipenderne affatto. L'inferenza on-device elimina del tutto questa variabile: la risposta viene calcolata a pochi centimetri dalla telecamera.
Le conseguenze di una scelta sbagliata sono ben documentate. Lo studio True Cost of Downtime di Siemens quantifica i fermi non pianificati in 1.400 miliardi di dollari all'anno per le 500 maggiori aziende al mondo, circa l'11% dei ricavi, con una linea automotive ferma che arriva a costare fino a 2,3 milioni di dollari all'ora (Siemens/Senseye, 2024). L'indagine ITIC del 2024 rileva che una sola ora costa oltre 300.000 dollari per più del 90% delle medie e grandi imprese (ITIC, 2024). Un'architettura AI che smette di funzionare quando si interrompe la WAN è un rischio di fermo che si è scelto di correre.
Quanto costa davvero inviare il video in streaming al cloud?
Facciamo i conti su una linea di dimensioni contenute. Prendiamo dieci telecamere di ispezione, ciascuna in streaming H.264 a 4 Mbps ipotizzati, un'impostazione comune per il video industriale 1080p. Sono 40 Mbps continui, circa 13 TB al mese. Il traffico in uscita dal cloud dalle region asiatiche su Azure è tariffato 0,12 dollari per GB dopo i primi 100 GB gratuiti (prezzi della larghezza di banda Azure), e la direzione di upload richiede un collegamento business simmetrico dimensionato sul picco, non sulla media.
La compressione aiuta, ma non cambia la natura del problema: Axis misura per il proprio codec Zipstream un risparmio medio del 50% o più rispetto all'H.264 standard (white paper Axis), il che lascia comunque terabyte in movimento ogni mese, per sempre. L'inferenza edge inverte il flusso: il video resta sulla rete di stabilimento e solo i risultati, un esito conforme o non conforme, il ritaglio di un difetto, un conteggio, viaggiano a monte nell'ordine dei kilobyte.
E per quanto riguarda la riservatezza dei dati e la continuità operativa?
Per molti produttori indiani il fattore decisivo non è il costo ma il controllo. Il video di produzione può rivelare processi proprietari, componenti dei clienti e persone: mantenerlo on-premise semplifica sia le questioni di riservatezza sia quelle di conformità. E un sistema edge continua a ispezionare durante un'interruzione dell'ISP, un incidente in una region cloud o una finestra di manutenzione; i risultati si sincronizzano quando il collegamento torna disponibile. La linea non aspetta internet.
Quando il cloud AI resta la scelta vincente?
In tre casi, e sostenere il contrario sarebbe disonesto. Addestramento: costruire o mettere a punto i modelli richiede una potenza GPU che uno stabilimento raramente possiede: la si noleggia nel cloud e si distribuisce poi il modello addestrato all'edge. Analisi di flotta: aggregare i risultati di molte linee o di più siti per dashboard e tendenze di lungo periodo è un compito naturalmente adatto al cloud, e il volume di dati è minimo perché l'edge lo ha già ridotto. Attività non in tempo reale: le verifiche di audit mensili o l'elaborazione documentale in batch non hanno vincoli di latenza. Lo schema che vince nella pratica è ibrido: addestrare nel cloud, inferire all'edge, aggregare nel cloud.
Come si porta l'edge AI in reparto?
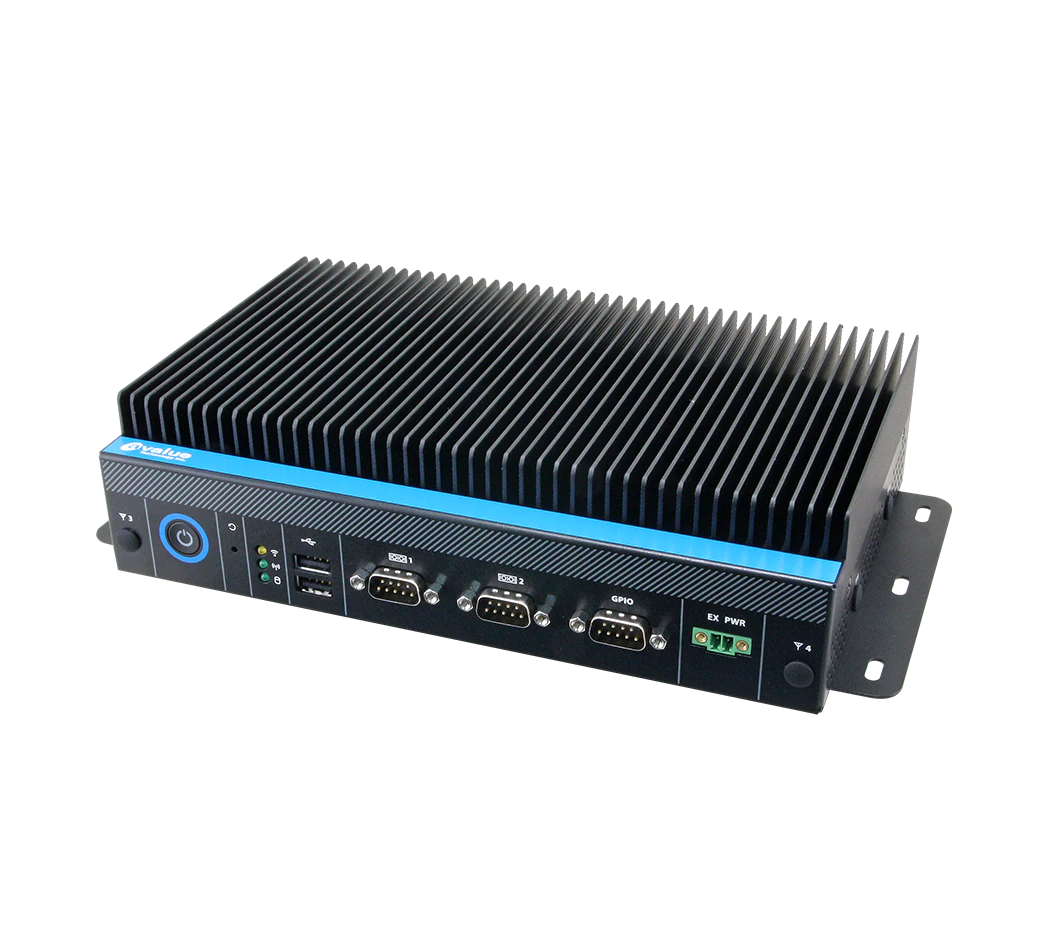
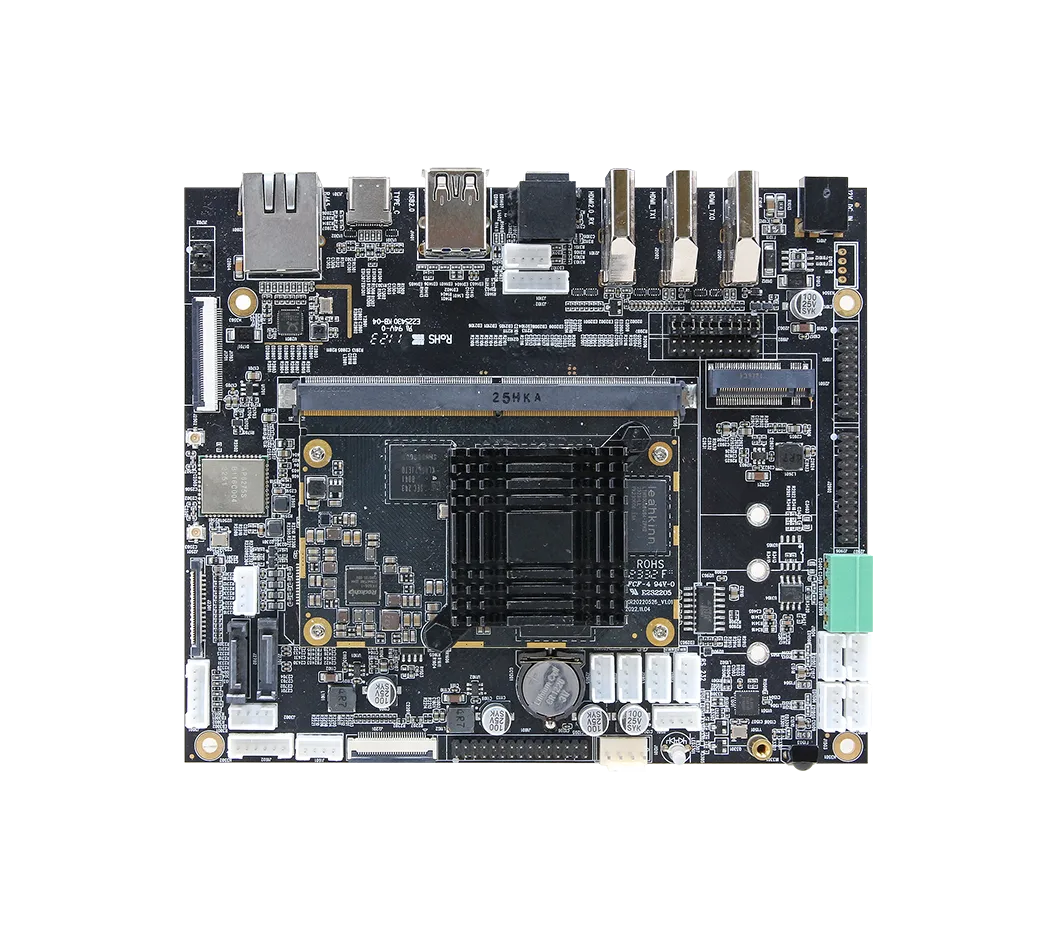
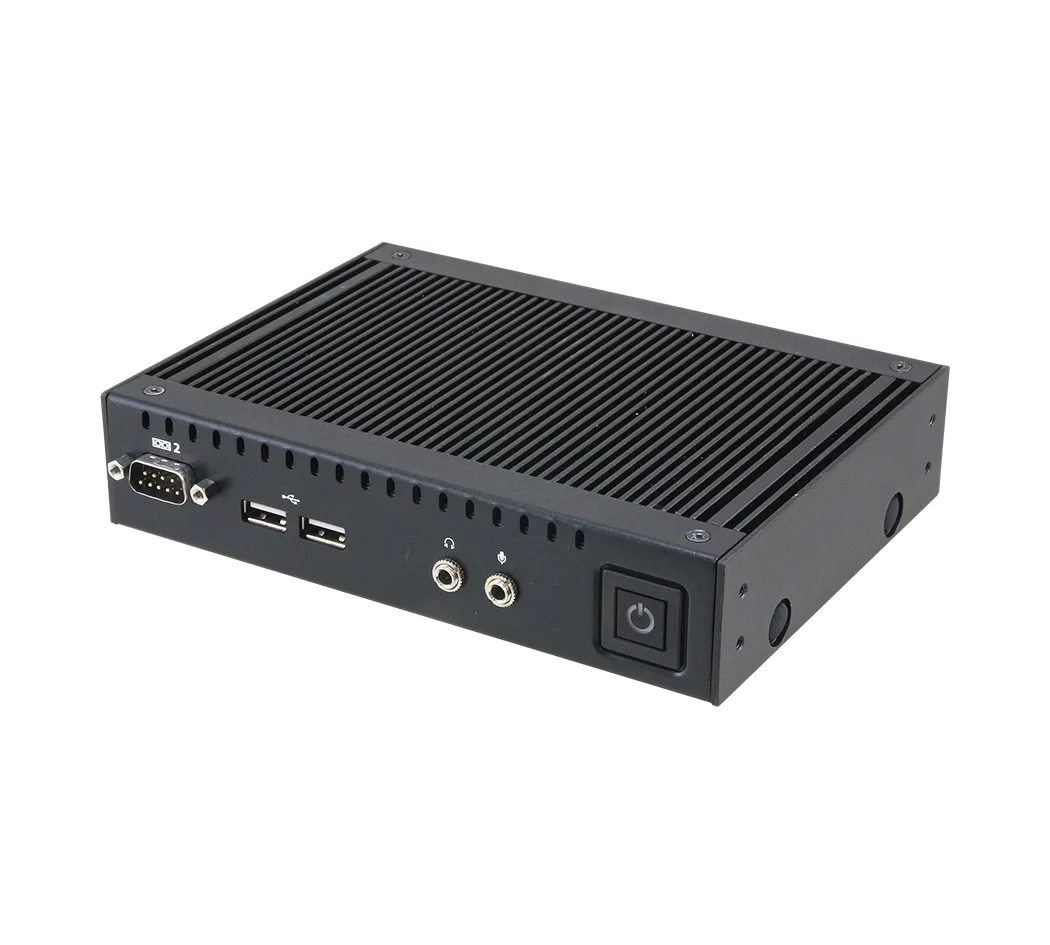
L'hardware è ormai la parte facile. Sistemi compatti senza ventola come l'Avalue EMS-ARH abbinano processori Intel Core Ultra a una NPU integrata per l'inferenza di visione in continuo, l'ACP-3588 porta una NPU da 6 TOPS su una scheda ARM senza ventola per installazioni sensibili al costo e le workstation con slot PCIe accolgono GPU discrete quando un solo sistema deve sorvegliare decine di flussi. Quale classe sia adatta al suo carico di lavoro è esattamente ciò che illustra la nostra guida all'acquisto di server edge AI e, se desidera il confronto a livello di silicio, veda la nostra guida su NPU vs GPU vs CPU per l'inferenza edge. Ci contatti per dimensionare una linea pilota: è un progetto più piccolo di quanto la maggior parte dei team si aspetti.
Domande frequenti
TSL Automation Solutions
Responsabile marketing, TSL Automation Solutions
Sanjana si occupa di tendenze dell'automazione industriale, lanci di prodotto e approfondimenti tecnologici per TSL Automation Solutions, distributore con sede a Mumbai di HMI, Panel PC e sistemi di computing embedded al servizio dei produttori in India e nel mondo.
Ha bisogno di aiuto per scegliere il prodotto giusto?
Il nostro team di Mumbai può consigliarle l'HMI, il Panel PC o il sistema embedded giusto per la sua applicazione.
Contatti TSL Automation