
IA en el borde o IA en la nube en la fabricación: latencia, ancho de banda y costes reales

Índice de contenidos
¿Cuál es la diferencia real entre la IA en el borde (edge AI) y la IA en la nube?
Dónde se ejecuta la inferencia. La IA en el borde ejecuta el modelo en hardware situado en la máquina o cerca de ella: un Box PC en el armario, un Panel PC en la línea. La IA en la nube envía los datos a un centro de datos remoto y devuelve la respuesta. El sector vota con su presupuesto: IDC sitúa el gasto mundial en computación en el borde en casi 261.000 millones de dólares en 2025, camino de 380.000 millones en 2028, con las cargas de trabajo de IA entre los motores de mayor crecimiento (IDC, mar. 2025).
Ninguno de los dos bandos lo gana todo. La decisión se reduce a tres cosas medibles: la latencia, el ancho de banda y lo que le cuesta una respuesta equivocada o un enlace caído.
¿A qué distancia está realmente la nube?
Microsoft publica los tiempos de ida y vuelta medidos entre sus regiones, y la geografía es contundente. Desde India Central, un viaje de ida y vuelta a India Sur ronda los 20 ms y a Jio India Oeste unos 29 ms, pero Europa Occidental está a unos 140 ms y Estados Unidos Este a unos 198 ms (estadísticas de latencia de red de Azure, 2026). Y eso es de centro de datos a centro de datos por la red troncal de Microsoft, antes de sumar el enlace de última milla de su planta, la sobrecarga de la VPN y el tiempo de cola de la inferencia.
Una comprobación de visión que gobierna un brazo de rechazo a 60 piezas por minuto tiene una ventana de decisión de un segundo; gastar 200 ms de ella en un viaje de ida y vuelta por la red, el doble contando el procesamiento, es viable hasta que el enlace sufre jitter. Un enclavamiento de seguridad o un lazo de control cerrado no pueden depender de ello en absoluto. La inferencia en el propio equipo elimina la variable por completo: la respuesta se calcula a centímetros de la cámara.
Lo que está en juego si esto se hace mal está bien documentado. El estudio True Cost of Downtime de Siemens cifra las paradas no planificadas en 1,4 billones de dólares al año para las 500 mayores empresas del mundo, alrededor del 11 % de sus ingresos, con una línea de automoción parada que cuesta hasta 2,3 millones de dólares por hora (Siemens/Senseye, 2024). La encuesta de 2024 de ITIC concluye que una sola hora cuesta más de 300.000 dólares a más del 90 % de las empresas medianas y grandes (ITIC, 2024). Una arquitectura de IA que deja de funcionar cuando cae la WAN es un riesgo de parada que usted ha elegido.
¿Cuánto cuesta realmente enviar vídeo a la nube?
Haga los números sobre una línea modesta. Tome diez cámaras de inspección, cada una transmitiendo en H.264 a unos 4 Mbps supuestos, un ajuste habitual para vídeo industrial 1080p. Eso son 40 Mbps continuos, aproximadamente 13 TB al mes. La salida de datos de la nube desde las regiones de Asia en Azure se factura a 0,12 dólares por GB después de los primeros 100 GB gratuitos (precios de ancho de banda de Azure), y el sentido de subida exige un enlace empresarial simétrico dimensionado para el pico, no para la media.
La compresión ayuda, pero no cambia la forma del problema: Axis mide que su códec Zipstream ahorra una media del 50 % o más frente al H.264 estándar (documento técnico de Axis), lo que sigue dejando terabytes en movimiento cada mes, para siempre. La inferencia en el borde invierte el flujo: el vídeo se queda en la red de la planta y solo los resultados, un apto o no apto, un recorte del defecto, un recuento, viajan aguas arriba en kilobytes.
¿Y la privacidad de los datos y la disponibilidad?
Para muchos fabricantes indios el factor decisivo no es el coste, sino el control. El vídeo de producción puede revelar procesos propios, piezas de clientes y personas; mantenerlo en las instalaciones simplifica tanto la confidencialidad como las conversaciones de cumplimiento normativo. Y un sistema en el borde sigue inspeccionando durante una caída del proveedor de internet, un incidente en una región de la nube o una ventana de mantenimiento; los resultados se sincronizan cuando vuelve el enlace. La línea no espera a internet.
¿Cuándo sigue ganando la IA en la nube?
En tres casos, y fingir lo contrario sería deshonesto. Entrenamiento: construir o ajustar modelos exige una potencia de GPU que una planta rara vez posee; alquílela en la nube y despliegue después el modelo entrenado en el borde. Analítica de flota: agregar resultados de muchas líneas o plantas para cuadros de mando y tendencias a largo plazo es un trabajo natural para la nube, y el volumen de datos es mínimo porque el borde ya lo redujo. Trabajo que no es en tiempo real: las auditorías mensuales o el procesamiento de documentos por lotes no tienen ninguna exigencia de latencia. El patrón que gana en la práctica es híbrido: entrenar en la nube, inferir en el borde, agregar en la nube.
¿Cómo se lleva la IA en el borde a la planta?
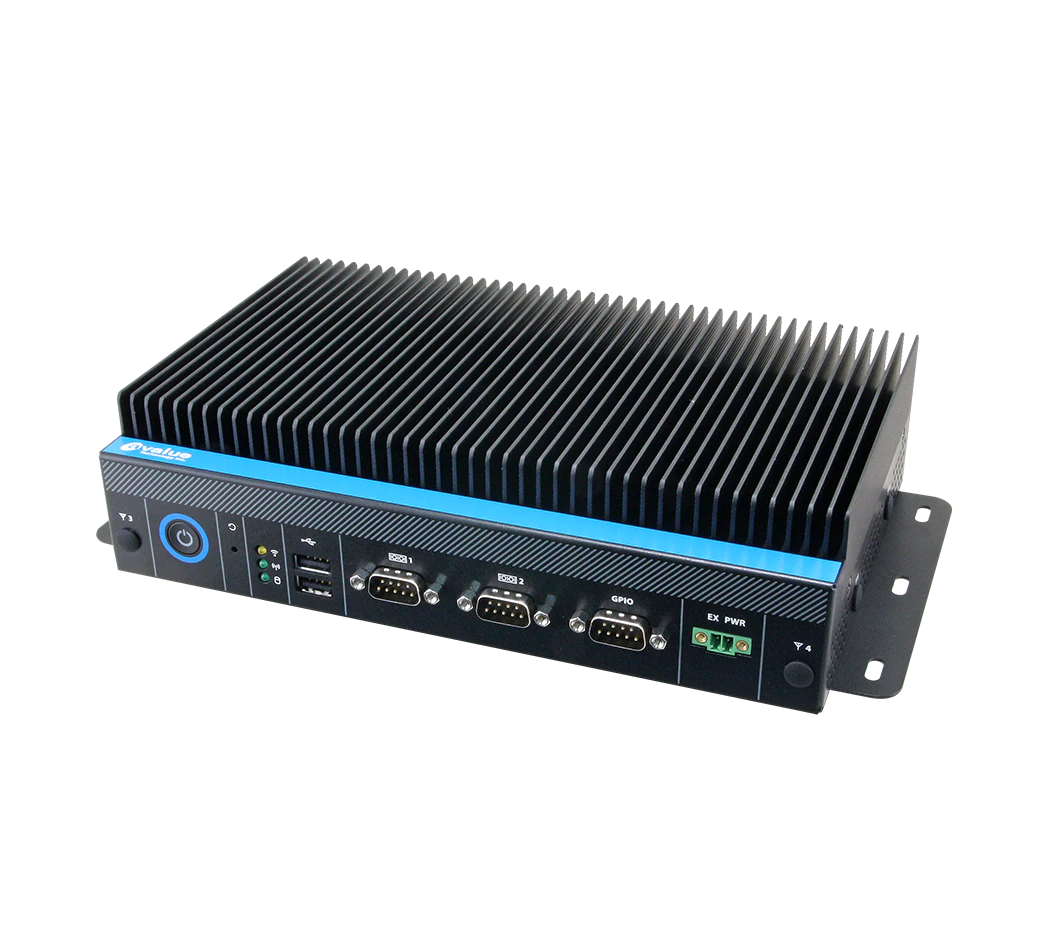
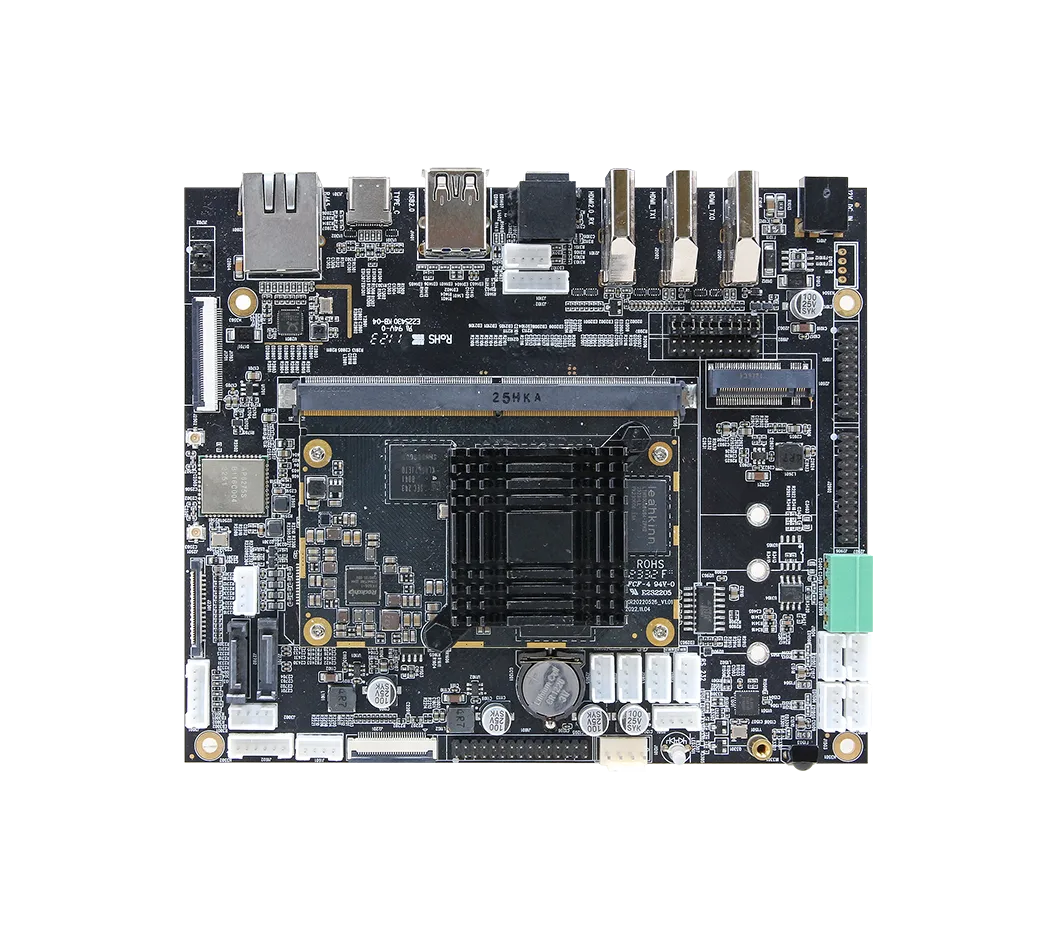
Hoy en día el hardware es la parte fácil. Los sistemas compactos sin ventilador como el Avalue EMS-ARH combinan procesadores Intel Core Ultra con una NPU integrada para inferencia de visión continua; el ACP-3588 lleva una NPU de 6 TOPS a una placa ARM sin ventilador para despliegues sensibles al coste, y las estaciones de trabajo con ranuras PCIe admiten GPU discretas cuando un solo sistema debe vigilar decenas de flujos. Qué clase encaja con su carga de trabajo es exactamente lo que recorre nuestra guía de compra de servidores de IA en el borde y, si quiere la comparación a nivel de silicio, consulte nuestra guía de NPU frente a GPU frente a CPU para inferencia en el borde. Hable con nosotros sobre cómo dimensionar una línea piloto: es un proyecto más pequeño de lo que la mayoría de los equipos espera.
Preguntas frecuentes
TSL Automation Solutions
Directora de Marketing, TSL Automation Solutions
Sanjana escribe sobre tendencias de automatización industrial, lanzamientos de producto y novedades tecnológicas para TSL Automation Solutions, distribuidor con sede en Mumbai de sistemas HMI, Panel PC y computación embebida al servicio de fabricantes de la India y de todo el mundo.
¿Necesita ayuda para elegir el producto adecuado?
Nuestro equipo en Mumbai puede recomendarle el HMI, el Panel PC o el sistema embebido adecuado para su aplicación.
Contactar con TSL AutomationProductos relacionados
Artículos relacionados

NPU, GPU o CPU: ¿qué silicio debe ejecutar su carga de IA en el borde?
17 ago 2026

Subida de los precios de la memoria en 2026: qué supone el alza de la DRAM para el comprador industrial
17 ago 2026
DDR5 frente a DDR4 en computación industrial: ¿necesita realmente DDR5?
20 may 2026