Edge-AI versus cloud-AI in de productie: latentie, bandbreedte en de echte kosten

Inhoudsopgave
Wat is het echte verschil tussen edge-AI en cloud-AI?
Waar de inferentie draait. Edge-AI voert het model uit op hardware bij of vlak bij de machine, een box-pc in de kast, een panel-pc aan de lijn. Cloud-AI stuurt de data naar een datacenter op afstand en krijgt het antwoord terug. De sector stemt met zijn budget: IDC becijfert de wereldwijde uitgaven aan edge computing op bijna 261 miljard dollar in 2025, op weg naar 380 miljard dollar in 2028, met AI-workloads als een van de snelst groeiende aanjagers (IDC, mrt. 2025).
Geen van beide wint op alle punten. De keuze komt neer op drie meetbare zaken: latentie, bandbreedte en wat een verkeerd antwoord of een weggevallen verbinding u kost.
Hoe ver weg is de cloud werkelijk?
Microsoft publiceert gemeten retourtijden tussen zijn regio's, en de geografie is genadeloos. Vanuit Central India duurt een retour naar South India ongeveer 20 ms en naar Jio India West ongeveer 29 ms, maar West Europe ligt op ruwweg 140 ms en East US op ongeveer 198 ms (statistieken over Azure-netwerklatentie, 2026). En dat is van datacenter tot datacenter over de backbone van Microsoft, nog vóór de last-mile-verbinding van uw fabriek, de VPN-overhead en de wachttijd in de inferentiewachtrij erbij komen.
Een visuele controle die een uitwerparm aanstuurt bij 60 delen per minuut heeft een beslissingsvenster van één seconde; daarvan 200 ms besteden aan een netwerkretour, het dubbele als de verwerking wordt meegeteld, is werkbaar tot de verbinding gaat schommelen. Een veiligheidsvergrendeling of een gesloten regelkring kan er helemaal niet van afhankelijk zijn. Inferentie op het apparaat haalt die variabele volledig weg: het antwoord wordt centimeters van de camera berekend.
Wat er op het spel staat als u dit verkeerd inschat, is goed gedocumenteerd. Het onderzoek True Cost of Downtime van Siemens becijfert ongeplande stilstand op 1,4 biljoen dollar per jaar voor de 500 grootste bedrijven ter wereld, ongeveer 11% van de omzet, waarbij een stilstaande autolijn tot 2,3 miljoen dollar per uur kost (Siemens/Senseye, 2024). Uit het onderzoek van ITIC uit 2024 blijkt dat één uur meer dan 300.000 dollar kost voor ruim 90% van de middelgrote en grote ondernemingen (ITIC, 2024). Een AI-architectuur die stopt met werken zodra het WAN uitvalt, is een stilstandsrisico dat u zelf hebt gekozen.
Wat kost het streamen van video naar de cloud werkelijk?
Reken het door voor een bescheiden lijn. Neem tien inspectiecamera's die elk H.264 streamen op naar schatting 4 Mbps, een gangbare instelling voor industriële 1080p-video. Dat is 40 Mbps continu, ruwweg 13 TB per maand. Cloud-egress vanuit de Azure-regio's in Azië kost 0,12 dollar per GB na de eerste 100 GB gratis (Azure-bandbreedteprijzen), en de uploadrichting vraagt om een symmetrische zakelijke verbinding die op de piek is gedimensioneerd, niet op het gemiddelde.
Compressie helpt, maar verandert niets aan de aard van het probleem: Axis meet voor zijn Zipstream-codec een besparing van gemiddeld 50% of meer ten opzichte van standaard H.264 (whitepaper van Axis), waarmee er nog altijd elke maand terabytes worden verplaatst, en dat blijvend. Edge-inferentie keert de stroom om: de video blijft op het fabrieksnetwerk en alleen de resultaten, een pass/fail, een uitsnede van een defect, een telling, gaan in kilobytes stroomopwaarts.
Hoe zit het met gegevensbescherming en beschikbaarheid?
Voor veel Indiase fabrikanten is niet de kosten maar de controle doorslaggevend. Productievideo kan bedrijfseigen processen, onderdelen van klanten en personen zichtbaar maken; die beelden op locatie houden vereenvoudigt zowel de vertrouwelijkheid als de gesprekken over compliance. En een edge-systeem blijft inspecteren tijdens een storing bij de internetprovider, een incident in een cloudregio of een onderhoudsvenster; de resultaten synchroniseren zodra de verbinding terug is. De lijn wacht niet op internet.
Wanneer wint cloud-AI nog steeds?
Op drie punten, en anders beweren zou oneerlijk zijn. Trainen: het bouwen of finetunen van modellen vraagt om GPU-kracht die een fabriek zelden bezit, huur die in de cloud en breng het getrainde model daarna naar de edge. Vlootanalyse: het samenvoegen van resultaten van veel lijnen of locaties voor dashboards en trends op lange termijn is een natuurlijke cloudtaak, het datavolume is klein omdat de edge het al heeft teruggebracht. Werk dat niet realtime is: maandelijkse auditrondes of batchgewijze documentverwerking hebben geen belang bij lage latentie. Het patroon dat in de praktijk wint, is hybride: trainen in de cloud, inferentie aan de edge, samenvoegen in de cloud.
Hoe brengt u edge-AI naar de werkvloer?
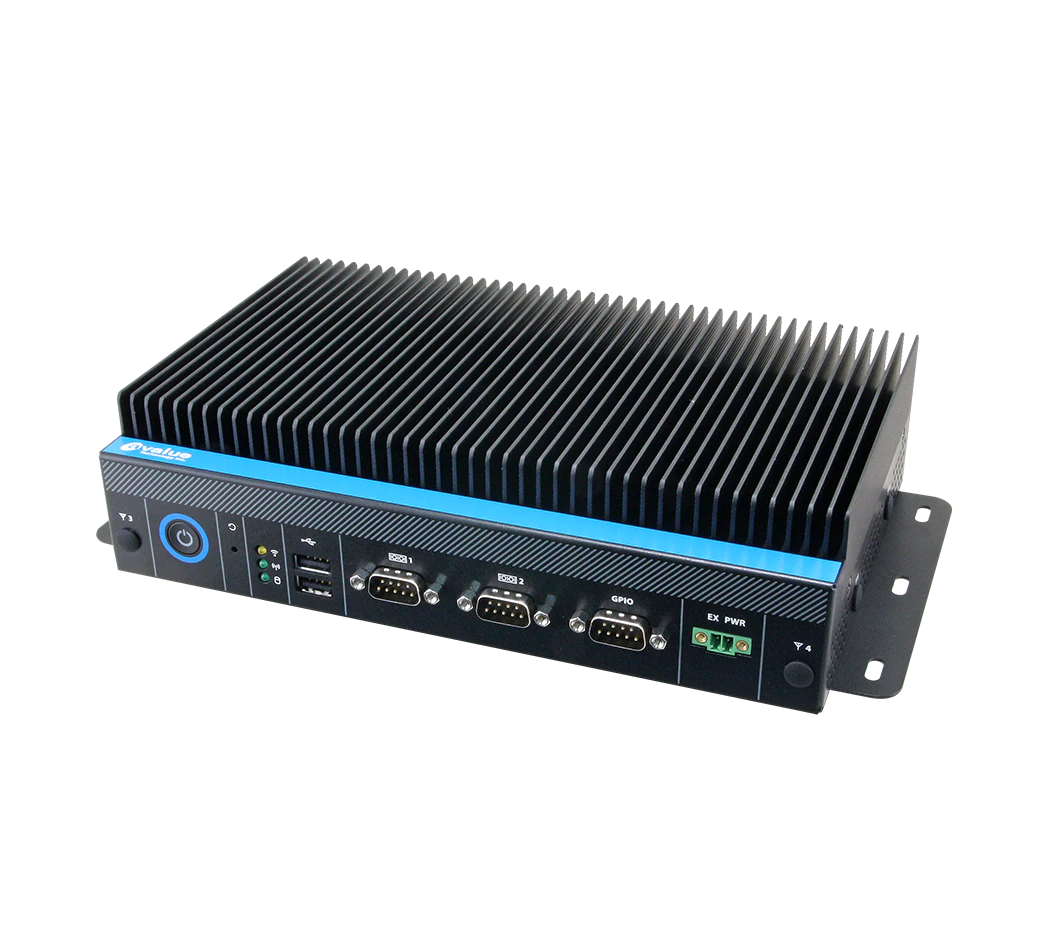
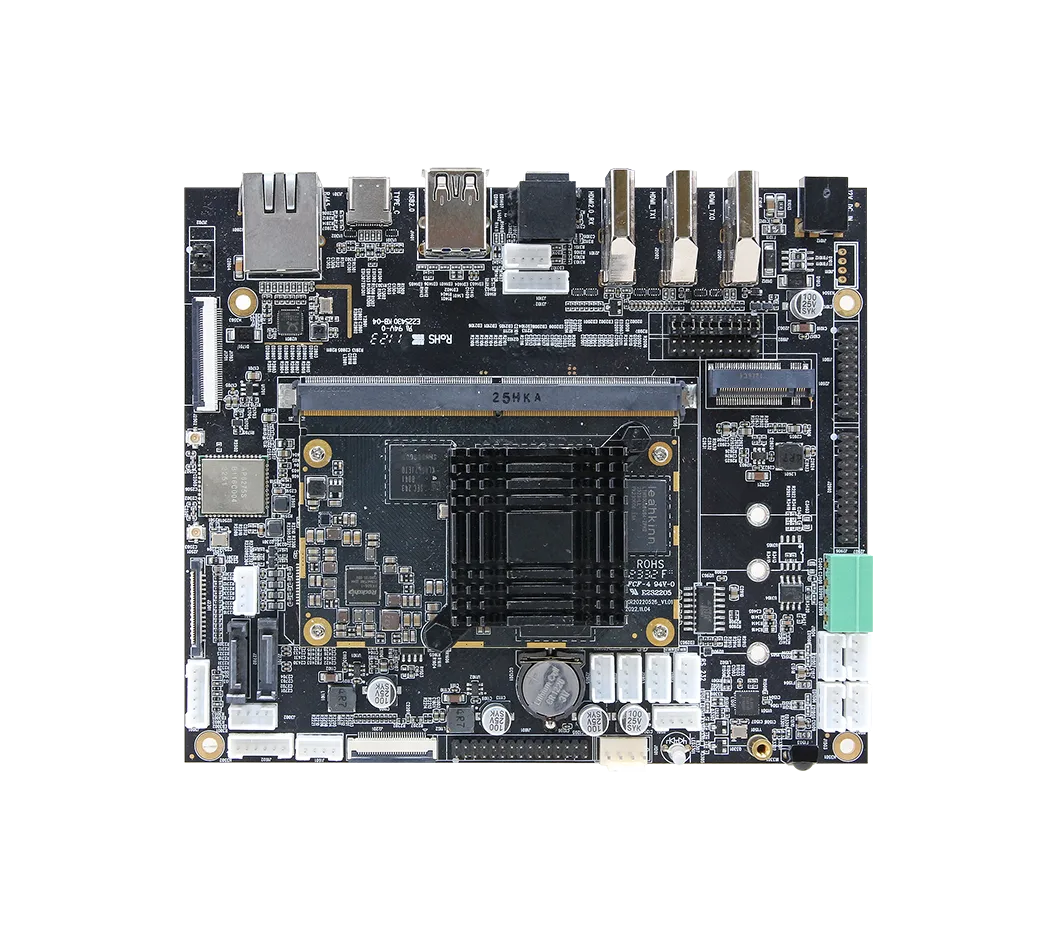
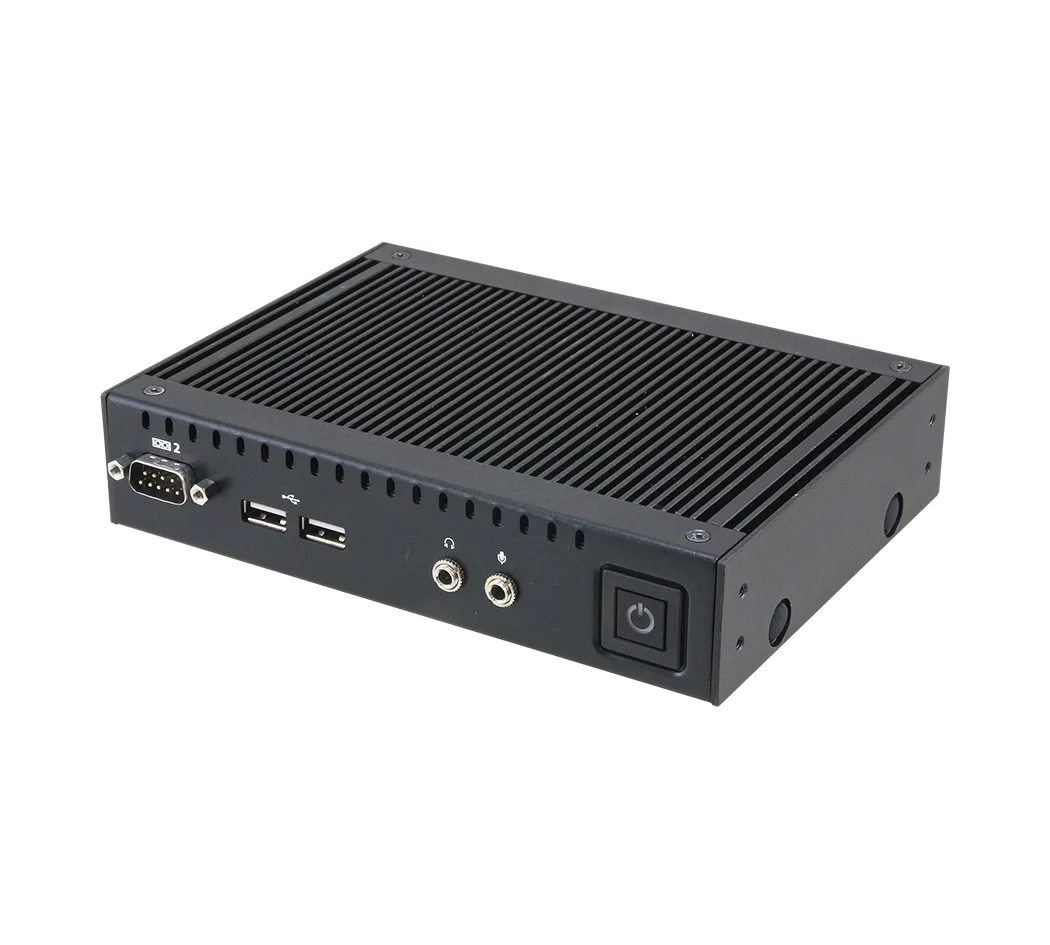
De hardware is tegenwoordig het eenvoudigste deel. Compacte ventilatorloze systemen zoals de Avalue EMS-ARH combineren Intel Core Ultra-processors met een geïntegreerde NPU voor continue visuele inferentie, de ACP-3588 zet een NPU van 6 TOPS op een ventilatorloos ARM-board voor kostengevoelige implementaties, en werkstations met PCIe-slots nemen losse GPU's op wanneer één systeem tientallen streams moet bewaken. Welke klasse bij uw workload past, is precies wat onze koopgids voor edge-AI-servers doorneemt, en wilt u de vergelijking op siliciumniveau, zie dan onze gids over NPU versus GPU versus CPU voor edge-inferentie. Praat met ons over het dimensioneren van een pilotlijn, het is een kleiner project dan de meeste teams verwachten.
Veelgestelde vragen
TSL Automation Solutions
Hoofd Marketing, TSL Automation Solutions
Sanjana schrijft over trends in industriële automatisering, productlanceringen en technologische inzichten voor TSL Automation Solutions, een in Mumbai gevestigde distributeur van HMI, panel-pc en embedded computersystemen voor fabrikanten in India en wereldwijd.
Hulp nodig bij het kiezen van het juiste product?
Ons team in Mumbai adviseert u over de juiste HMI, panel-pc of het juiste embedded systeem voor uw toepassing.
Neem contact op met TSL Automation