Edge AI czy AI w chmurze w produkcji? Opóźnienia, pasmo i realne koszty

Spis treści
Jaka jest prawdziwa różnica między edge AI a AI w chmurze?
Miejsce, w którym wykonywane jest wnioskowanie. Edge AI uruchamia model na sprzęcie przy maszynie lub w jej pobliżu: komputerze typu box w szafie sterowniczej, panelu PC na linii. AI w chmurze wysyła dane do odległego centrum danych i zwraca odpowiedź. Branża głosuje budżetem: IDC szacuje światowe wydatki na przetwarzanie brzegowe na blisko 261 miliardów dolarów w 2025 roku, zmierzające do 380 miliardów dolarów do 2028 roku, przy czym obciążenia AI należą do najszybciej rosnących czynników wzrostu (IDC, marzec 2025).
Żadna ze stron nie wygrywa we wszystkim. Decyzja sprowadza się do trzech mierzalnych rzeczy: opóźnienia, przepustowości oraz tego, ile kosztuje Państwa błędna odpowiedź lub zerwane łącze.
Jak daleko naprawdę jest chmura?
Microsoft publikuje zmierzone czasy podróży w obie strony między swoimi regionami, a geografia nie pozostawia złudzeń. Z regionu Central India podróż w obie strony do South India trwa około 20 ms, a do Jio India West około 29 ms, ale West Europe jest oddalone o mniej więcej 140 ms, a East US o około 198 ms (statystyki opóźnień sieci Azure, 2026). A są to pomiary z centrum danych do centrum danych po szkielecie sieci Microsoftu, zanim doliczy się łącze ostatniej mili w Państwa zakładzie, narzut VPN i czas oczekiwania w kolejce wnioskowania.
Kontrola wizyjna sterująca ramieniem odrzutu przy 60 detalach na minutę ma okno decyzyjne o długości jednej sekundy, poświęcenie 200 ms z niego na podróż przez sieć, a dwa razy tyle po doliczeniu przetwarzania, jest wykonalne do momentu, gdy łącze zacznie się wahać. Blokada bezpieczeństwa lub zamknięta pętla regulacji nie może od tego zależeć w ogóle. Wnioskowanie na urządzeniu całkowicie eliminuje tę zmienną: odpowiedź jest obliczana centymetry od kamery.
Stawka błędnej decyzji jest dobrze udokumentowana. Badanie Siemensa True Cost of Downtime wycenia nieplanowane przestoje na 1,4 biliona dolarów rocznie dla 500 największych firm świata, około 11% ich przychodów, przy czym unieruchomiona linia motoryzacyjna kosztuje nawet 2,3 miliona dolarów za godzinę (Siemens/Senseye, 2024). Badanie ITIC z 2024 roku wykazuje, że pojedyncza godzina kosztuje ponad 300 000 dolarów w przypadku ponad 90% średnich i dużych przedsiębiorstw (ITIC, 2024). Architektura AI, która przestaje działać wraz z siecią WAN, to ryzyko przestoju, które wybrali Państwo sami.
Ile faktycznie kosztuje przesyłanie strumienia wideo do chmury?
Proszę policzyć to na przykładzie skromnej linii. Weźmy dziesięć kamer kontrolnych, każda przesyłająca strumień H.264 z zakładaną przepływnością 4 Mb/s, typowym ustawieniem dla przemysłowego wideo 1080p. Daje to 40 Mb/s w trybie ciągłym, czyli mniej więcej 13 TB miesięcznie. Ruch wychodzący z chmury w regionach azjatyckich Azure jest wyceniany na 0,12 dolara za GB po pierwszych darmowych 100 GB (cennik przepustowości Azure), a kierunek wysyłania wymaga symetrycznego łącza biznesowego zwymiarowanego pod szczyt, a nie pod średnią.
Kompresja pomaga, ale nie zmienia natury problemu: Axis podaje, że jego kodek Zipstream oszczędza średnio 50% lub więcej w porównaniu ze standardowym H.264 (biała księga Axis), co i tak pozostawia terabajty przesyłane co miesiąc, bez końca. Wnioskowanie na brzegu sieci odwraca ten przepływ: wideo pozostaje w sieci zakładowej, a w górę wędrują tylko wyniki, ocena dobry lub zły, wycinek z defektem, licznik, mierzone w kilobajtach.
A co z prywatnością danych i dostępnością?
Dla wielu indyjskich producentów czynnikiem decydującym nie jest koszt, lecz kontrola. Wideo z produkcji może ujawniać autorskie procesy, części klientów i ludzi, a pozostawienie go lokalnie upraszcza zarówno kwestie poufności, jak i rozmowy o zgodności z przepisami. System brzegowy prowadzi też kontrolę podczas awarii dostawcy internetu, incydentu w regionie chmury czy okna serwisowego, a wyniki synchronizują się po powrocie łącza. Linia nie czeka na internet.
Kiedy AI w chmurze nadal wygrywa?
W trzech obszarach, a udawanie, że jest inaczej, byłoby nieuczciwe. Trenowanie: budowanie lub dostrajanie modeli wymaga mocy GPU, której zakład rzadko posiada, warto ją wynająć w chmurze, a następnie wdrożyć wytrenowany model na brzegu sieci. Analityka floty: agregowanie wyników z wielu linii lub lokalizacji na potrzeby pulpitów i długoterminowych trendów to naturalne zadanie dla chmury, a ilość danych jest niewielka, ponieważ brzeg sieci już ją zredukował. Praca poza czasem rzeczywistym: comiesięczne przebiegi audytowe czy wsadowe przetwarzanie dokumentów nie mają żadnej stawki związanej z opóźnieniem. Wzorzec, który wygrywa w praktyce, jest hybrydowy: trenować w chmurze, wnioskować na brzegu, agregować w chmurze.
Jak wdrożyć edge AI na hali produkcyjnej?
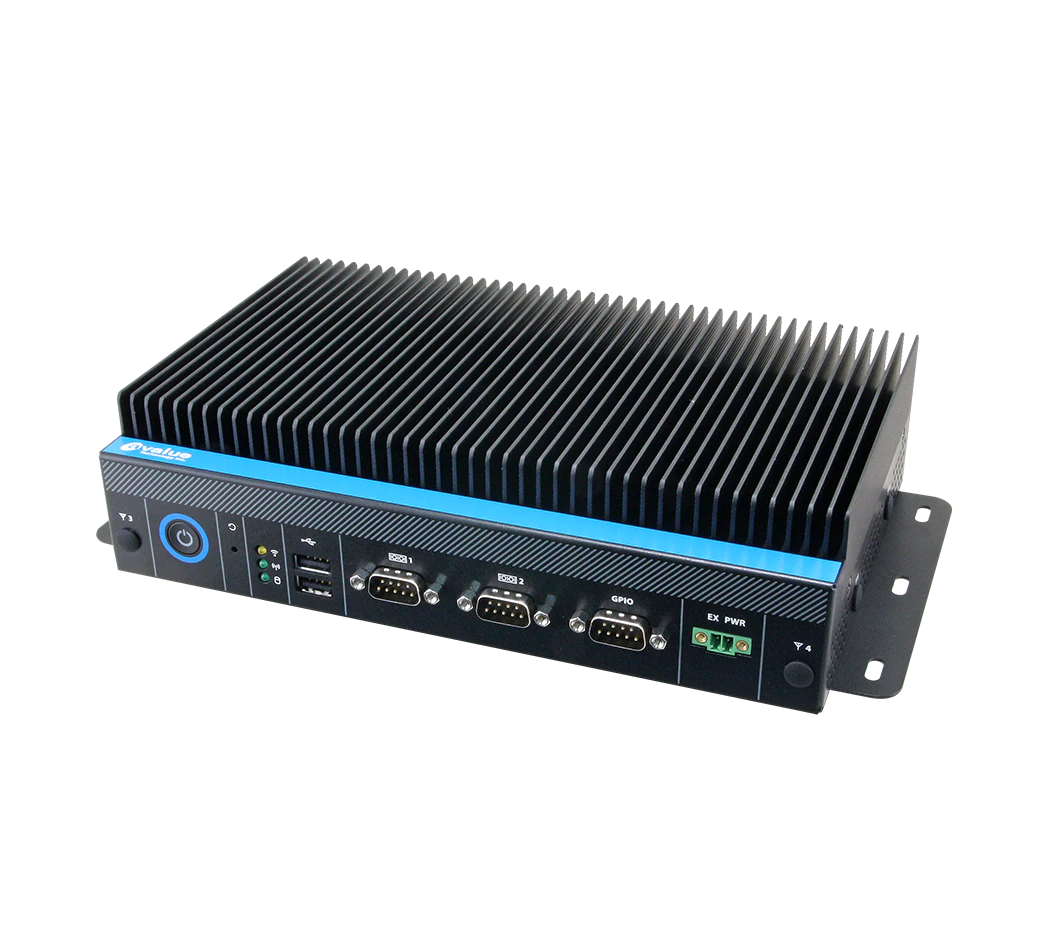
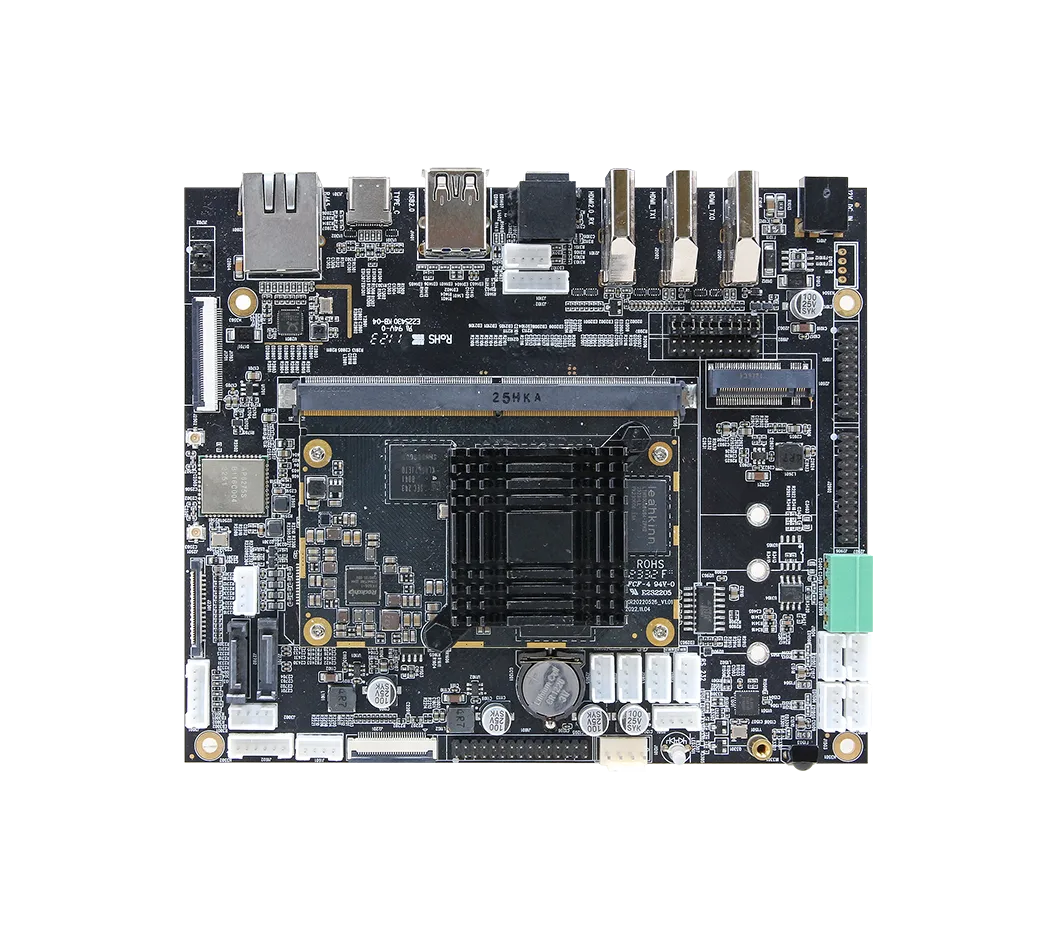
Sprzęt jest dziś łatwiejszą częścią. Kompaktowe systemy bezwentylatorowe, takie jak Avalue EMS-ARH, łączą procesory Intel Core Ultra ze zintegrowanym NPU do ciągłego wnioskowania wizyjnego, ACP-3588 umieszcza NPU o mocy 6 TOPS na bezwentylatorowej płycie ARM dla wdrożeń wrażliwych na koszty, a stacje robocze z gniazdami PCIe przyjmują dedykowane karty GPU, gdy jeden system musi obserwować dziesiątki strumieni. Która klasa pasuje do Państwa obciążenia, wyjaśnia dokładnie nasz przewodnik kupującego serwer edge AI, a jeżeli chcą Państwo porównania na poziomie układów scalonych, zapraszamy do naszego przewodnika NPU vs GPU vs CPU we wnioskowaniu brzegowym. Proszę porozmawiać z nami o zwymiarowaniu linii pilotażowej, to mniejszy projekt, niż spodziewa się większość zespołów.
Często zadawane pytania
TSL Automation Solutions
Dyrektor marketingu, TSL Automation Solutions
Sanjana pisze o trendach w automatyce przemysłowej, premierach produktów i nowych technologiach dla TSL Automation Solutions, dystrybutora paneli HMI, paneli PC i systemów wbudowanych z siedzibą w Mumbaju, obsługującego producentów w Indiach i na całym świecie.
Potrzebna pomoc w wyborze właściwego produktu?
Nasz zespół w Mumbaju doradzi odpowiedni panel HMI, panel PC lub system wbudowany do Państwa zastosowania.
Kontakt z TSL Automation