
Come dimensionare la GPU per l'ispezione AI con visione: Jetson, RTX o Xeon-6 dual-GPU?
Indice dei contenuti
Perché "basta comprare una GPU" non funziona
Un sistema industriale di visione artificiale con AI ha tre limiti rigidi: il frame rate alla velocità della linea, la dimensione del modello (parametri + risoluzione dell'immagine in ingresso) e il budget di latenza dall'acquisizione della telecamera alla decisione dell'attuatore. Se sceglie una GPU troppo piccola perde frame; se la sceglie troppo grande ha speso troppo e sovradimensionato il raffreddamento. Il dimensionamento corretto nasce da questi tre numeri e da un semplice calcolo di capacità.
Il calcolo di capacità in un paragrafo
Per una singola telecamera a F FPS che esegue un modello con una inferenza misurata di L ms per immagine su una GPU di riferimento, l'utilizzo della GPU per telecamera è all'incirca F × L / 1000. Una telecamera a 30 FPS con un modello da 20 ms occupa il 60% di uno stream; una linea con 8 telecamere a 30 FPS con lo stesso modello richiede circa 4,8 stream. Qualunque sia la GPU di riferimento, validi il valore reale di L su un campione prima di decidere: i valori MIPS/TOPS dichiarati dal produttore non sono la latenza di inferenza.
I tre livelli
Livello 1: classe Jetson sulla telecamera
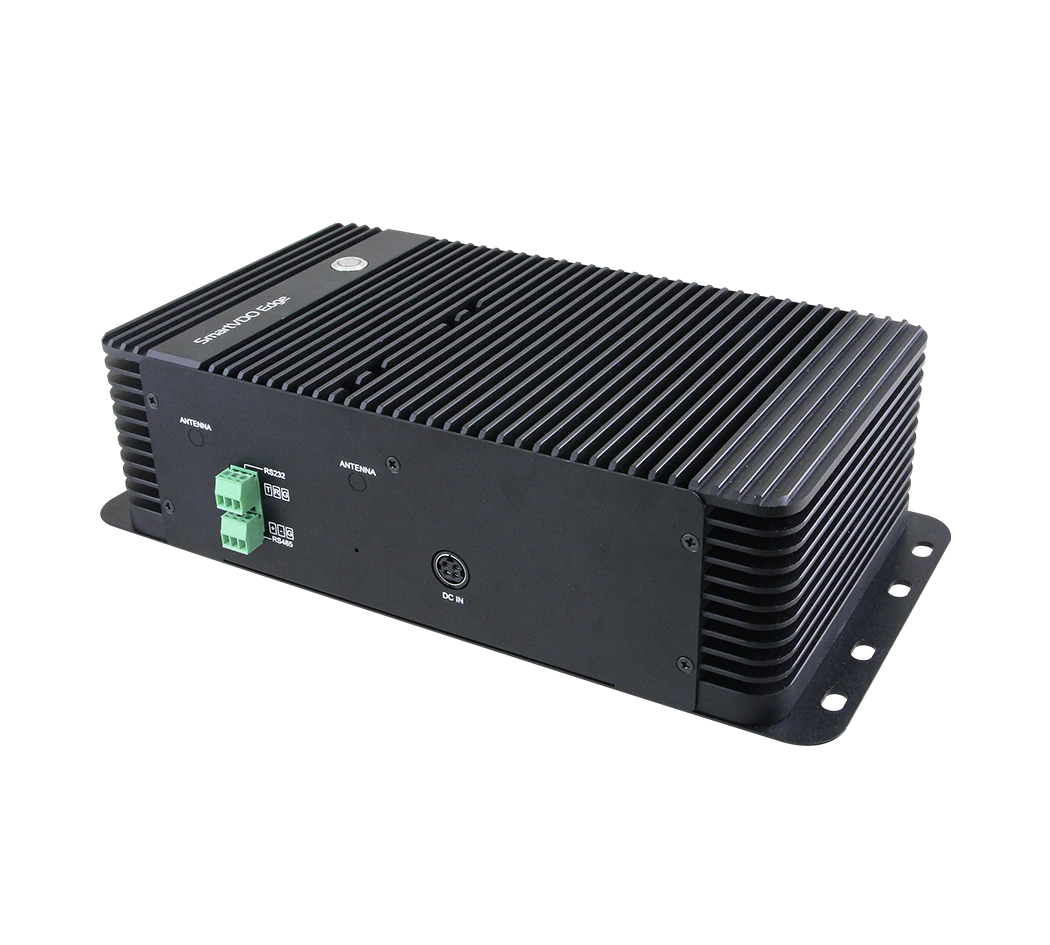
I moduli NVIDIA Jetson Orin / NX sono adatti a ispezioni con una sola telecamera o con poche telecamere, dove la GPU si trova sulla telecamera stessa o in una piccola box in linea. Fascia di potenza da circa 10 a 60 W, senza ventola o con ventola silenziosa, installabile in quadri su guida DIN o a parete. Ideale per: ispezione puntuale, OCR semplice, controllo presenza/assenza, lettura di strumenti. Consulti le piattaforme NVIDIA Solution di Avalue, tra cui AIB-NIAO-S, AIB-NINX-S e AIB-NW01.
Livello 2: RTX Ada in un Box PC AI
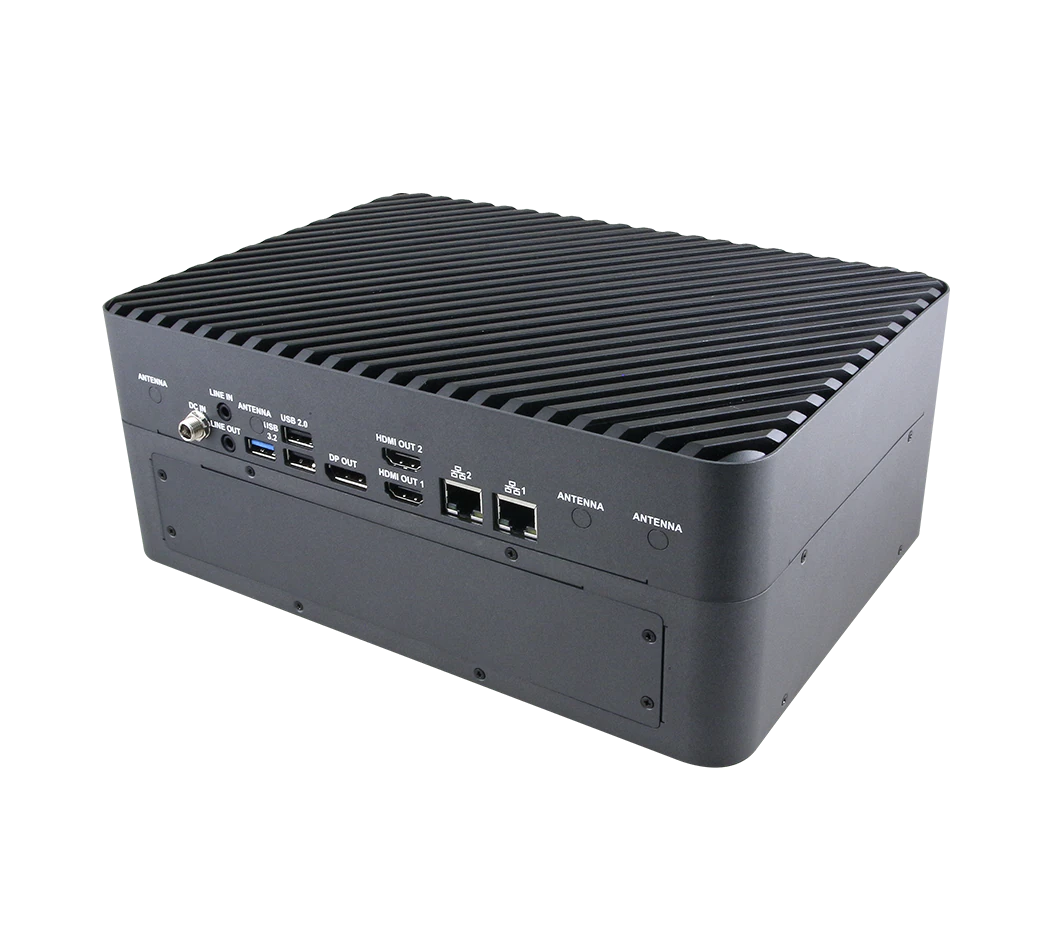
Per linee multi telecamera (da 4 a 8 telecamere), ingressi ad alta risoluzione o teste di modelli 3D, la soluzione ideale è un Box PC industriale con una singola GPU discreta RTX Ada (per esempio una RTX 2000E Ada in un contenitore industriale sigillato). Potenza da circa 70 a 200 W sulla GPU, PCIe Gen4 x16, espandibile per frame grabber. Il MAB-T660D appartiene a questo livello (RTX 2000E Ada, PCIe Gen4 x16). Consulti il nostro approfondimento su MAB-T690/T660D per l'architettura completa.
Livello 3: server Xeon-6 con GPU a doppio slot
Per la visione centralizzata con molte telecamere, ricostruzioni 3D di grandi dimensioni, farm AOI o addestramento e aggiornamento dei modelli, subentra un server 1U/2U con una o due GPU a doppio slot e PCIe Gen5. Il portafoglio Edge HPC di Avalue comprende il sistema 1U HPS-GNRU1A basato su un singolo processore Intel Xeon 6 (fino a 350 W di TDP) con espansione GPU FHFL, e il server HPS-GNRU4A che supporta quattro GPU a doppio slot su PCIe Gen5. Consulti il nostro approfondimento su Edge HPC.
Come scegliere
- Elenchi le telecamere, la loro risoluzione e il frame rate.
- Scelga il modello candidato (YOLO/Mask-RCNN/transformer personalizzato) e misuri la latenza di inferenza su una GPU candidata con un batch di immagini rappresentativo.
- Moltiplichi: domanda totale di stream = Σ (F × L / 1000) su tutte le telecamere.
- Aggiunga circa il 30% di margine per il preprocessing delle immagini, il drift e i futuri aggiornamenti del modello.
- Scelga il livello più piccolo che copre la domanda e rispetta il budget di latenza: Livello 1 se il totale è < uno stream Jetson, Livello 2 per linee multi telecamera con un solo box, Livello 3 per carichi di lavoro centralizzati su più linee o di addestramento.
Errori da evitare
- Dimensionare sui TOPS invece che sugli FPS misurati
- Dimenticare alimentazione e raffreddamento: una RTX Ada in un contenitore sigillato può andare in throttling termico durante l'estate
- Collo di bottiglia con una sola GPU quando un frame grabber richiede la banda PCIe Gen5 x16
- Nessun percorso di aggiornamento quando il modello viene sostituito da uno più grande un anno dopo
Il ruolo di TSL Automation
TSL Automation fornisce tutti e tre i livelli: piattaforme AIB di classe Jetson, Box PC dotati di RTX Ada e server GPU Xeon-6. Contatti il nostro team indicando il numero di telecamere, il frame rate, il modello e il budget di latenza e selezioneremo il livello più piccolo in grado di soddisfarlo.
Domande frequenti
TSL Automation Solutions
Responsabile marketing, TSL Automation Solutions
Sanjana si occupa di tendenze dell'automazione industriale, lanci di prodotto e approfondimenti tecnologici per TSL Automation Solutions, distributore con sede a Mumbai di HMI, Panel PC e sistemi di computing embedded al servizio dei produttori in India e nel mondo.
Ha bisogno di aiuto per scegliere il prodotto giusto?
Il nostro team di Mumbai può consigliarle l'HMI, il Panel PC o il sistema embedded giusto per la sua applicazione.
Contatti TSL AutomationProdotti correlati
Articoli correlati

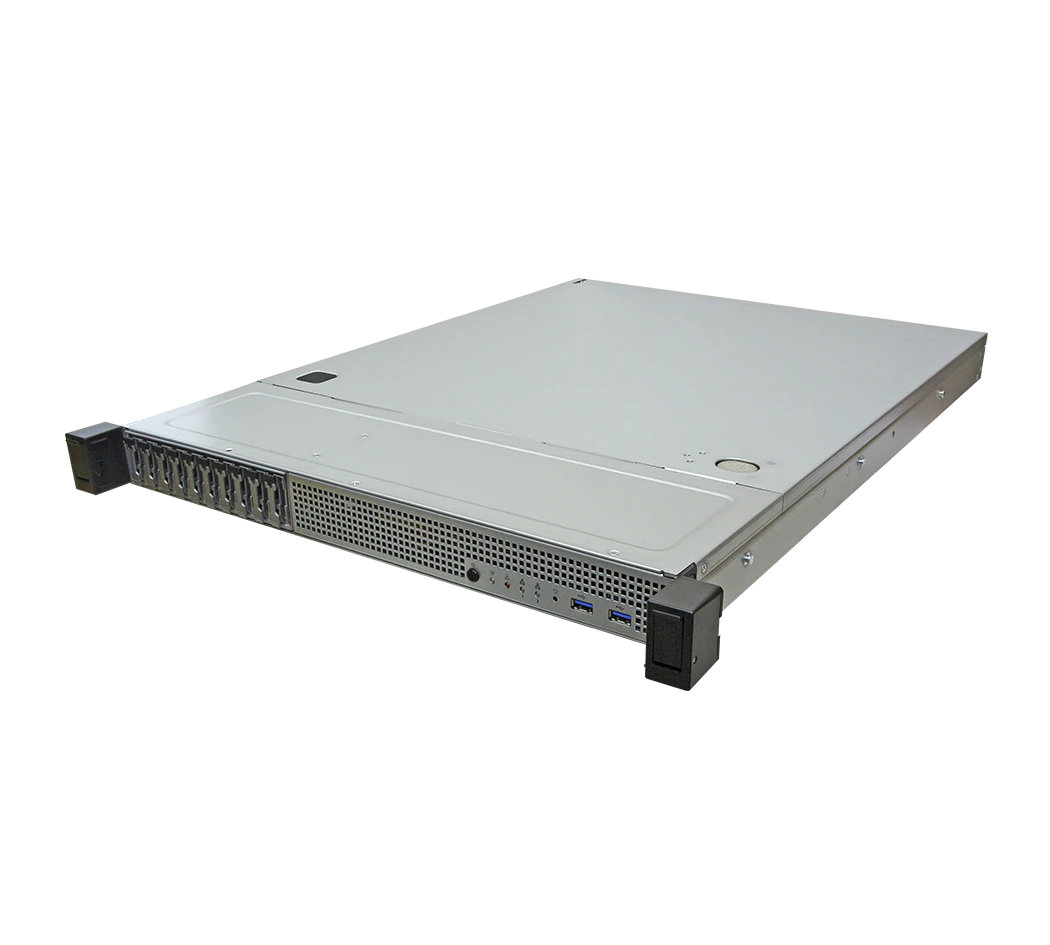
Come scegliere un server edge AI: guida all'acquisto per AI in loco & visione artificiale
4 ago 2026
Panel PC Android o Windows per chioschi self-service e ristorazione rapida: quale scegliere?
20 mag 2026
COM Express, SMARC o Qseven: quale standard Computer-on-Module (COM) scegliere?
20 mag 2026