
Cómo dimensionar la GPU para la inspección de visión con IA industrial: ¿Jetson, RTX o Xeon-6 con doble GPU?
Índice de contenidos
Por qué "comprar sin más una GPU" no funciona
Un sistema industrial de visión con IA tiene tres límites duros: la velocidad de fotogramas a la velocidad de la línea, el tamaño del modelo (parámetros más resolución de la imagen de entrada) y el presupuesto de latencia desde la captura de la cámara hasta la decisión del actuador. Si elige una GPU demasiado pequeña, perderá fotogramas; si la elige demasiado grande, habrá gastado y refrigerado de más. El dimensionamiento correcto sale de esos tres números y de un poco de aritmética de capacidad.
La aritmética de capacidad en un párrafo
Para una sola cámara a F FPS que ejecuta un modelo con una latencia de inferencia medida de L ms por imagen en una GPU objetivo, la utilización de GPU por cámara es aproximadamente F × L / 1000. Una cámara de 30 FPS con un modelo de 20 ms usa el 60 % de un flujo; una línea de 8 cámaras a 30 FPS con el mismo modelo necesita unos 4,8 flujos. Sea cual sea su GPU objetivo, valide la L real sobre una muestra antes de comprometerse: las cifras de MIPS/TOPS del fabricante no son latencia de inferencia.
Los tres niveles
Nivel 1: clase Jetson junto a la cámara
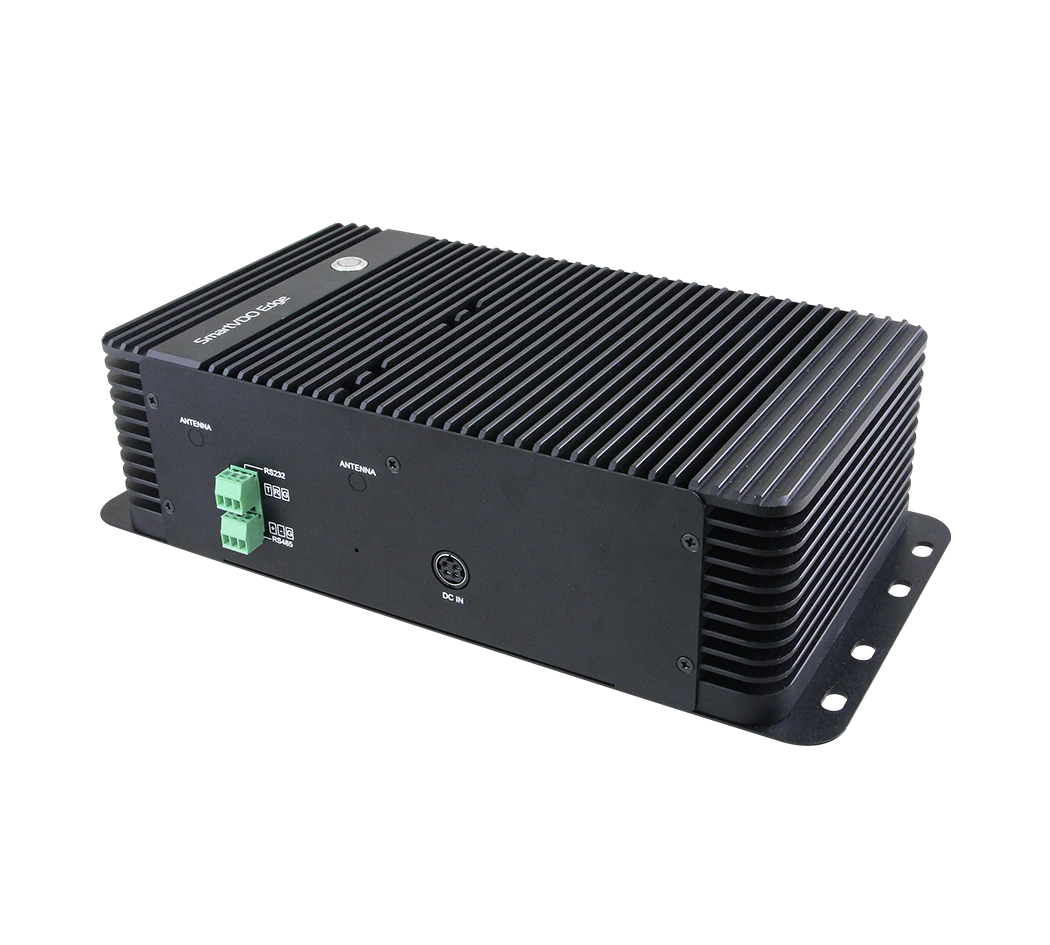
Los módulos NVIDIA Jetson Orin / NX encajan en inspecciones de una o pocas cámaras en las que la GPU se sitúa junto a la cámara o en una pequeña caja en línea. Envolvente de potencia de unos 10 a 60 W, sin ventilador o con ventilador de bajo ruido, desplegable en armarios de carril DIN o de montaje en pared. Ideal para: inspección puntual, OCR sencillo, presencia/ausencia, lectura de indicadores. Vea las plataformas NVIDIA Solution de Avalue, entre ellas AIB-NIAO-S, AIB-NINX-S y AIB-NW01.
Nivel 2: RTX Ada en un Box PC de IA
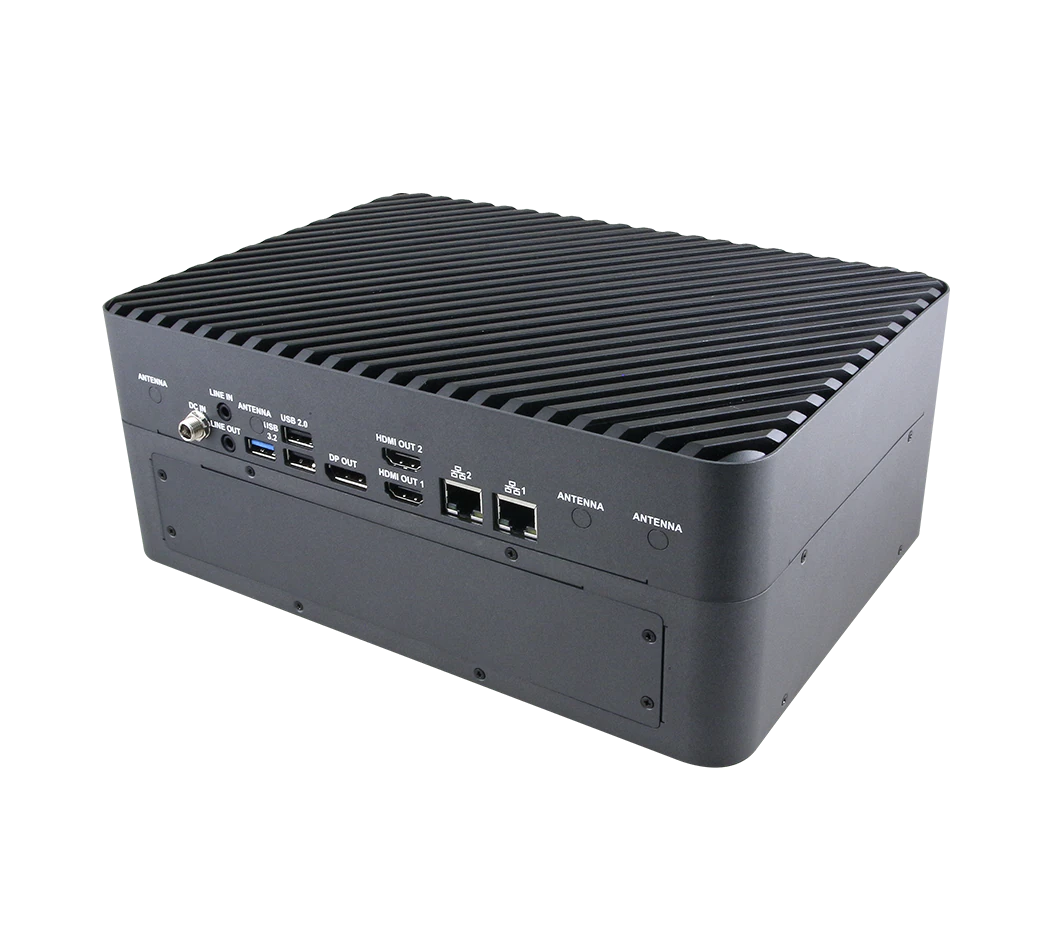
Para líneas multicámara (de 4 a 8 cámaras), entrada de alta resolución o cabezales de modelo 3D, un Box PC industrial con una única RTX Ada discreta (por ejemplo, una RTX 2000E Ada en una caja industrial sellada) es el punto óptimo. Potencia de unos 70 a 200 W en la GPU, PCIe Gen4 x16, ampliable para capturadoras de imagen. El MAB-T660D se sitúa en este nivel (RTX 2000E Ada, PCIe Gen4 x16). Consulte nuestra cobertura del MAB-T690/T660D para ver la arquitectura completa.
Nivel 3: servidor Xeon 6 con GPU de doble ancho
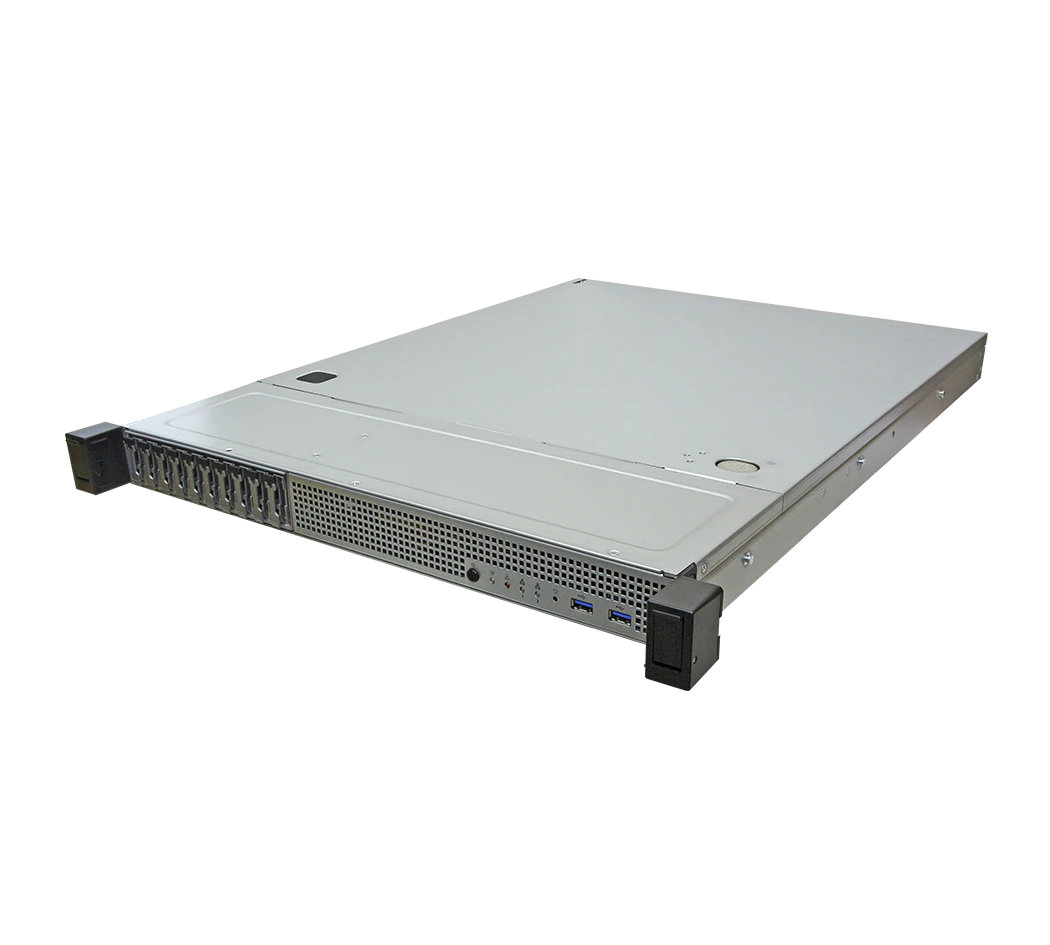
Para visión centralizada con muchas cámaras, reconstrucción 3D de gran tamaño, granjas de AOI o entrenamiento y actualización de modelos, toma el relevo un servidor 1U/2U con una o dos GPU de doble ancho y PCIe Gen5. La gama Edge HPC de Avalue incluye el sistema 1U HPS-GNRU1A sobre un único procesador Intel Xeon 6 (hasta 350 W de TDP) con expansión de GPU FHFL, y el servidor HPS-GNRU4A, compatible con cuatro GPU de doble ancho sobre PCIe Gen5. Consulte nuestra cobertura de Edge HPC.
Cómo elegir
- Enumere las cámaras, su resolución y su velocidad de fotogramas.
- Elija el modelo candidato (YOLO/Mask-RCNN/transformer propio) y mida la latencia de inferencia en una GPU candidata con un lote de imágenes representativo.
- Multiplique: demanda total de flujos = Σ (F × L / 1000) en todas las cámaras.
- Añada alrededor de un 30 % de margen para el preprocesado de imagen, la deriva y futuras actualizaciones del modelo.
- Elija el nivel más pequeño que cubra la demanda y cumpla el presupuesto de latencia: Nivel 1 si el total es < un flujo de Jetson, Nivel 2 para líneas multicámara de una sola caja, Nivel 3 para cargas centralizadas multilínea o de entrenamiento.
Errores que evitar
- Dimensionar por TOPS en lugar de por FPS medidos
- Olvidar la potencia y la refrigeración: una RTX Ada en una caja sellada puede sufrir limitación térmica en verano
- Cuello de botella de una sola GPU cuando una capturadora de imagen necesita el ancho de banda de PCIe Gen5 x16
- No tener ruta de ampliación cuando el modelo se sustituya por otro mayor un año después
Dónde encaja TSL Automation
TSL Automation suministra los tres niveles: plataformas AIB de clase Jetson, Box PC equipados con RTX Ada y servidores Xeon 6 con GPU. Póngase en contacto con nuestro equipo indicando su número de cámaras, su velocidad de fotogramas, su modelo y su presupuesto de latencia y le preseleccionaremos el nivel más pequeño que lo cubra.
Preguntas frecuentes
TSL Automation Solutions
Directora de Marketing, TSL Automation Solutions
Sanjana escribe sobre tendencias de automatización industrial, lanzamientos de producto y novedades tecnológicas para TSL Automation Solutions, distribuidor con sede en Mumbai de sistemas HMI, Panel PC y computación embebida al servicio de fabricantes de la India y de todo el mundo.
¿Necesita ayuda para elegir el producto adecuado?
Nuestro equipo en Mumbai puede recomendarle el HMI, el Panel PC o el sistema embebido adecuado para su aplicación.
Contactar con TSL AutomationProductos relacionados
Artículos relacionados

Cómo elegir un servidor de IA en el borde: guía de compra para IA in situ & visión artificial
4 ago 2026
Panel PC Android o Windows para quioscos de autoservicio y restauración rápida: ¿cuál elegir?
20 may 2026
COM Express, SMARC o Qseven: ¿qué estándar de Computer-on-Module (COM) elegir?
20 may 2026