
NPU, GPU o CPU: ¿qué silicio debe ejecutar su carga de IA en el borde?

Índice de contenidos
¿Por qué importa tanto la elección del silicio?
Porque los presupuestos de IA en el borde (edge AI) son ya dinero de verdad. El mercado de hardware de edge AI alcanzó los 26.140 millones de dólares en 2025 y se prevé que llegue a 58.900 millones en 2030, con una tasa de crecimiento anual compuesta del 17,6 % (MarketsandMarkets, 2025). Si elige un silicio demasiado pequeño, la línea se le quedará corta en un año; demasiado grande y habrá pagado precio de GPU para contar botellas. La buena noticia: las tres clases, CPU, NPU y GPU, dividen el espacio de cargas de trabajo con más claridad de lo que sugiere el marketing.
¿Cuándo basta con una CPU normal?
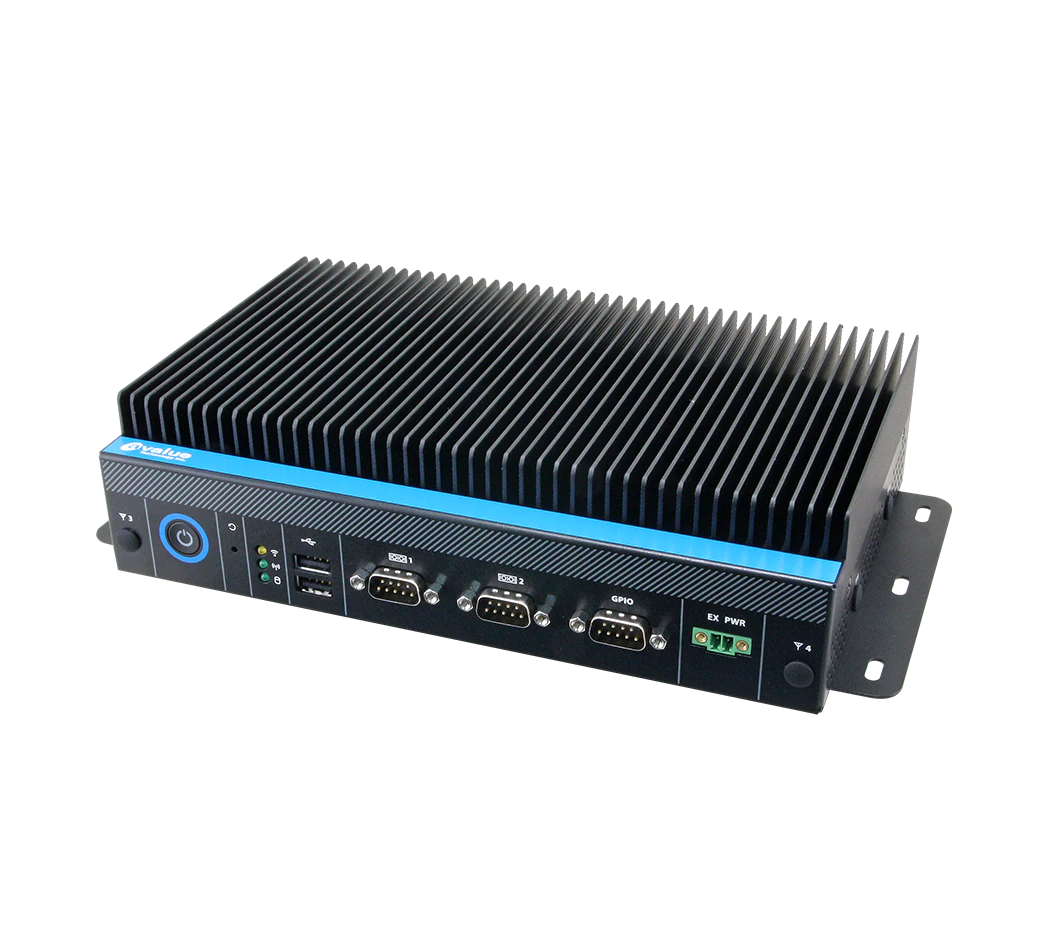
Más a menudo de lo que admiten los fabricantes. Los modelos modestos con ciclos de trabajo modestos, la lectura de códigos de barras con OCR ocasional, una clasificación cada pocos segundos, las comprobaciones de anomalías sobre datos de sensores, funcionan de forma aceptable en los mismos procesadores de clase Atom y Celeron que ya llevan dentro los Box PC industriales como el NUC-EHL. Sin hardware adicional, sin un nuevo diseño térmico, sin un segundo proveedor.
La palanca que hace viables las CPU es la cuantización. La documentación de LiteRT de Google mide que la cuantización completa a INT8 reduce MobileNet-v1 de 16,9 MB a 4,3 MB, unas 4 veces menos, a la vez que recorta la latencia de 124 ms a 64 ms en el mismo hardware (documentación de Google LiteRT). Si su modelo cuantizado cumple su tiempo de ciclo en la CPU que ya tiene, ha terminado: gaste el ahorro en otra cosa.
¿Qué le aporta realmente una NPU?
Inferencia sostenida sin los vatios. Una unidad de procesamiento neuronal es un motor de función fija para la aritmética de multiplicación y acumulación de la que están hechas las redes neuronales, y los ejemplos actuales muestran la escala: la plataforma Intel Core Ultra 200V ofrece hasta 120 TOPS de plataforma, de los cuales la NPU aporta 48 TOPS INT8 (Intel Newsroom, 2024; The Register, 2024). En el lado ARM, el RK3588 de Rockchip integra una NPU de 6 TOPS compatible con precisiones de INT4 a FP16 (Rockchip, oficial). Los módulos aceleradores dedicados llevan la eficiencia aún más lejos: el Hailo-8 de Hailo se sitúa en 26 TOPS con un consumo típico de 2,5 W (Hailo, oficial).
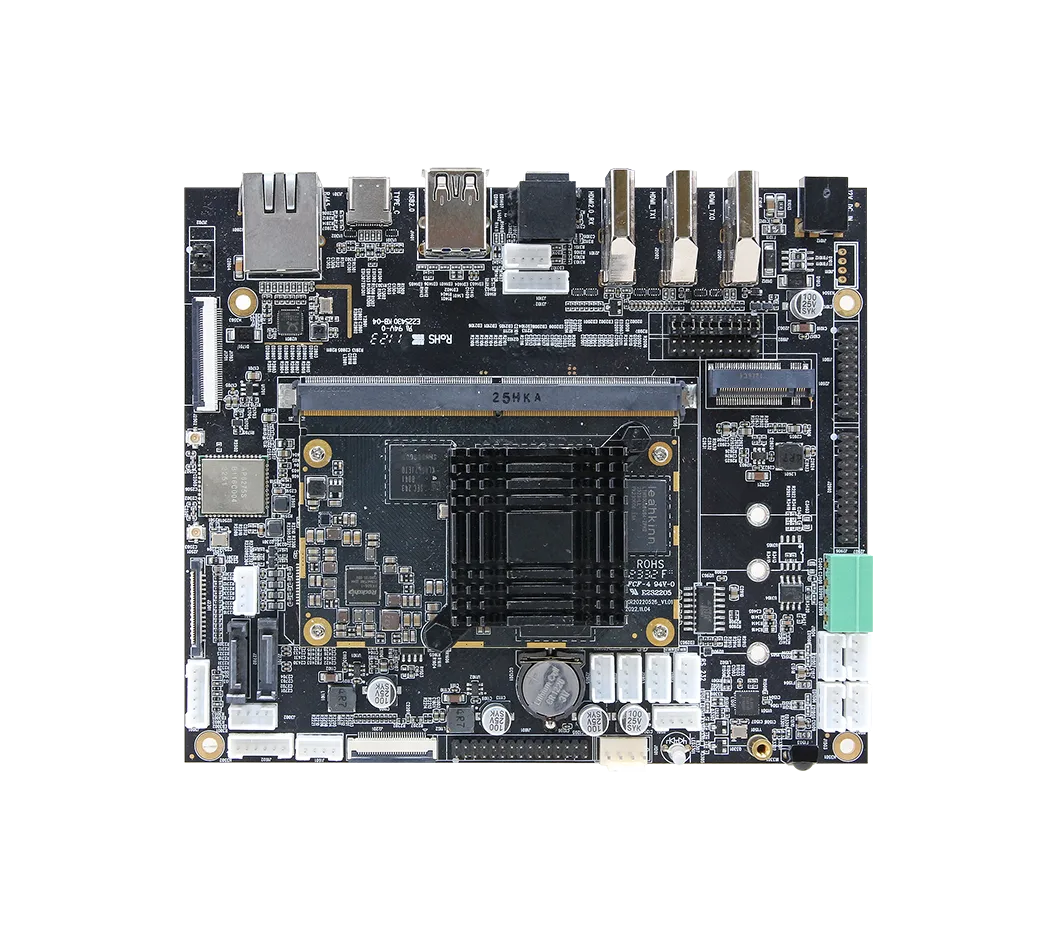
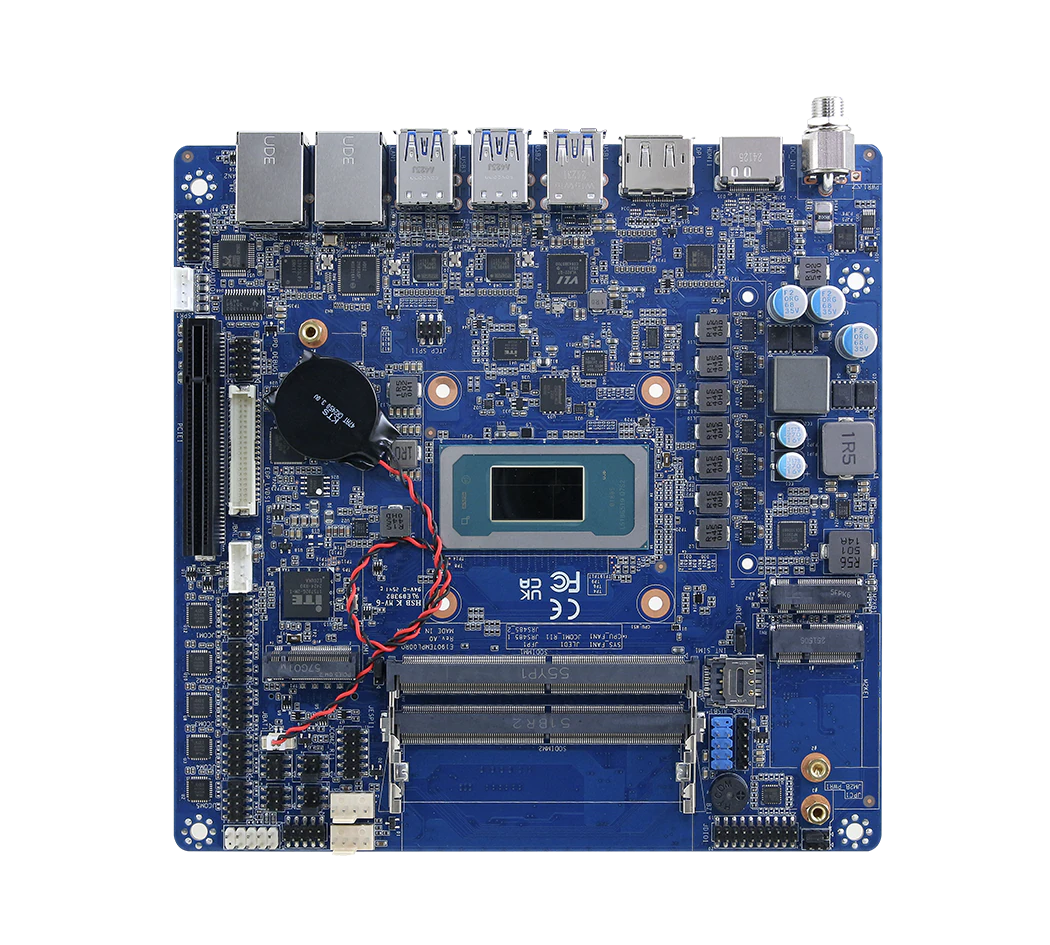
El significado práctico: uno o unos pocos flujos de cámara continuos, detección de defectos, monitorización de presencia, puertas de calidad, funcionando todo el turno dentro de una envolvente térmica sin ventilador. En nuestro catálogo esa es la clase Core Ultra: el Box PC EMS-ARH, el Panel PC APC-2146 y la placa EMX-PTLP llevan todos NPU integradas y, en ARM, el ACP-3588 lleva los 6 TOPS del RK3588 a un precio de SBC sin ventilador.
¿Cuándo necesita una GPU?
Cuando el número de flujos o el tamaño del modelo superan a los motores de función fija. La línea Jetson Orin embebida de NVIDIA ilustra el techo: hasta 275 TOPS con 15 a 60 W en AGX Orin, 157 TOPS en Orin NX, 67 TOPS en Orin Nano (NVIDIA, oficial). Las GPU PCIe discretas van todavía más lejos, con cientos de vatios.
Las GPU justifican ese presupuesto de potencia en tres situaciones: muchos flujos simultáneos alimentando un solo sistema, una estación de AOI que vigila una docena de cámaras; modelos grandes o sin cuantizar, redes de segmentación, cargas de clase LLM; y la iteración rápida, en la que la madurez del software de CUDA acorta el desarrollo. El patrón de hardware es una estación de trabajo con ranuras PCIe y refrigeración adecuadas; en nuestra gama, esa es la clase HPS-ERSUTA, especificada con la GPU que necesite su framework.
¿Cómo debería decidir en la práctica?
Trabaje hacia atrás desde la línea, no hacia delante desde los TOPS. Cuente los flujos (una cámara o doce), fije el tiempo de ciclo (una decisión cada 50 ms o cada 5 s), dimensione el modelo (un clasificador cuantizado o una red de segmentación) y fije el presupuesto de carcasa (armario sellado sin ventilador o rack ventilado). Después: trabajo ligero en un solo flujo, CPU. Visión continua en uno o unos pocos flujos dentro de una caja sin ventilador, NPU. Muchos flujos o modelos pesados con refrigeración disponible, GPU.
Y trate los TOPS como un número de entrada, no como un veredicto. Las cifras mezclan precisiones (INT8 frente a FP16 prácticamente duplica el recuento), suponen una utilización ideal y no dicen nada sobre el comportamiento de memoria de su modelo. La prueba honesta es su modelo, cuantizado tal y como lo va a desplegar, sobre el hardware candidato. Ese dimensionamiento basado primero en pruebas comparativas es exactamente como lo abordamos en nuestra guía de compra de servidores de IA en el borde y, si la pregunta de borde o nube sigue abierta, empiece por nuestra comparación entre borde y nube. Tráiganos su número de cámaras y su tiempo de ciclo, y le preseleccionaremos hardware que pueda someter a pruebas comparativas.
Preguntas frecuentes
TSL Automation Solutions
Directora de Marketing, TSL Automation Solutions
Sanjana escribe sobre tendencias de automatización industrial, lanzamientos de producto y novedades tecnológicas para TSL Automation Solutions, distribuidor con sede en Mumbai de sistemas HMI, Panel PC y computación embebida al servicio de fabricantes de la India y de todo el mundo.
¿Necesita ayuda para elegir el producto adecuado?
Nuestro equipo en Mumbai puede recomendarle el HMI, el Panel PC o el sistema embebido adecuado para su aplicación.
Contactar con TSL AutomationProductos relacionados
Artículos relacionados

IA en el borde o IA en la nube en la fabricación: latencia, ancho de banda y costes reales
17 ago 2026

Subida de los precios de la memoria en 2026: qué supone el alza de la DRAM para el comprador industrial
17 ago 2026
DDR5 frente a DDR4 en computación industrial: ¿necesita realmente DDR5?
20 may 2026