
NPU, GPU ou CPU : quelle puce pour votre charge d'IA embarquée ?

Sommaire
Pourquoi le choix du silicium compte-t-il autant ?
Parce que les budgets d'IA embarquée représentent aujourd'hui de vraies sommes. Le marché du matériel d'edge AI a atteint 26,14 milliards de dollars en 2025 et devrait atteindre 58,90 milliards de dollars d'ici 2030, soit un TCAC de 17,6 % (MarketsandMarkets, 2025). Choisissez un silicium trop petit et la ligne le dépassera en un an ; trop grand, et vous aurez payé le prix d'un GPU pour compter des bouteilles. La bonne nouvelle : les trois classes, CPU, NPU et GPU, découpent l'espace des charges de travail plus nettement que ne le laisse entendre le marketing.
Quand un simple CPU suffit-il ?
Plus souvent que les fournisseurs ne l'admettent. Des modèles modestes à taux d'utilisation modeste, la lecture de codes-barres avec de l'OCR occasionnel, une classification toutes les quelques secondes, des contrôles d'anomalies sur des données de capteurs, s'exécutent correctement sur les mêmes processeurs de classe Atom et Celeron déjà présents dans les Box PC industriels comme le NUC-EHL. Pas de matériel supplémentaire, pas de nouvelle conception thermique, pas de second fournisseur.
Le levier qui rend les CPU viables, c'est la quantification. La documentation LiteRT de Google mesure qu'une quantification INT8 complète fait passer MobileNet-v1 de 16,9 MB à 4,3 MB, soit environ 4 fois moins, tout en réduisant la latence de 124 ms à 64 ms sur le même matériel (documentation Google LiteRT). Si votre modèle quantifié respecte son temps de cycle sur le CPU que vous possédez déjà, c'est terminé : dépensez les économies ailleurs.
Qu'apporte réellement un NPU ?
De l'inférence soutenue sans les watts. Une unité de traitement neuronal est un moteur à fonction figée dédié aux multiplications-accumulations dont sont faits les réseaux de neurones, et les exemples actuels donnent l'échelle : la plateforme Intel Core Ultra 200V délivre jusqu'à 120 TOPS au niveau plateforme, dont 48 TOPS INT8 apportés par le NPU (Intel Newsroom, 2024 ; The Register, 2024). Côté ARM, le RK3588 de Rockchip intègre un NPU de 6 TOPS prenant en charge les précisions de INT4 à FP16 (Rockchip, officiel). Les modules accélérateurs dédiés poussent l'efficacité encore plus loin : le Hailo-8 de Hailo est annoncé à 26 TOPS pour 2,5 W typiques (Hailo, officiel).
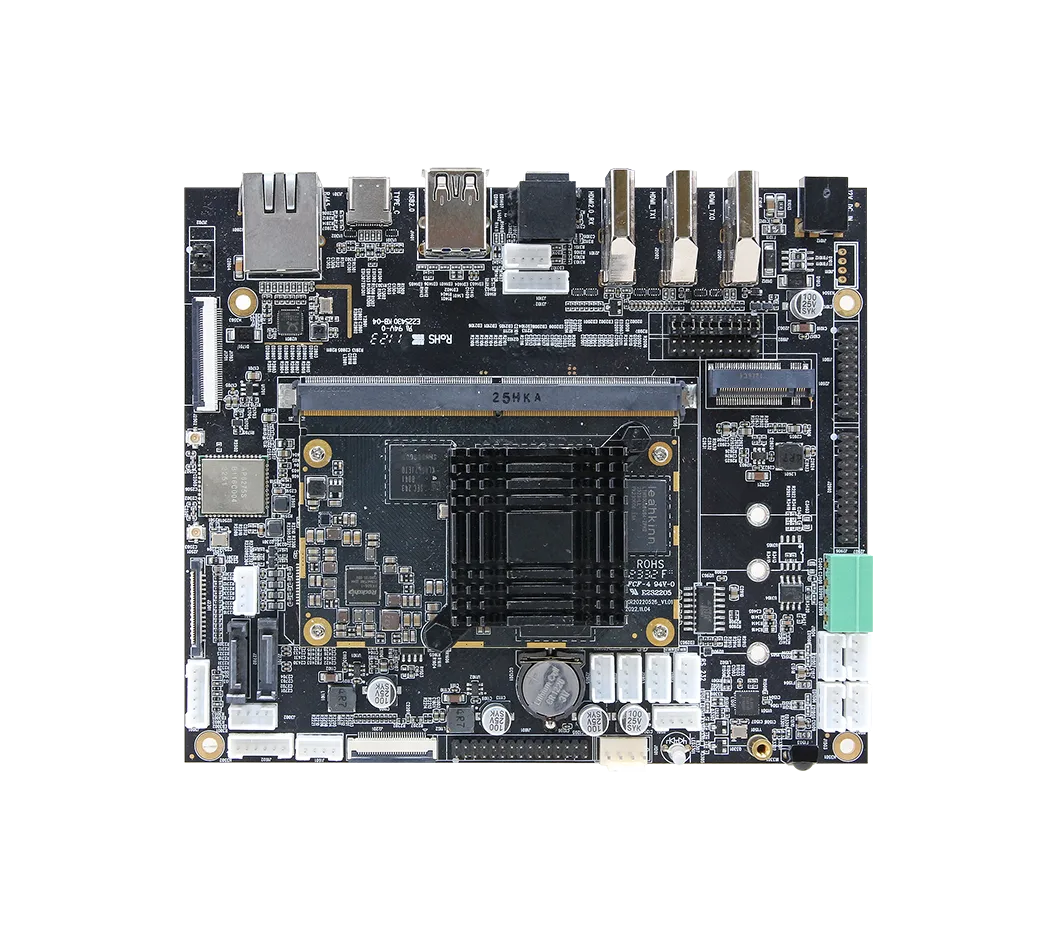
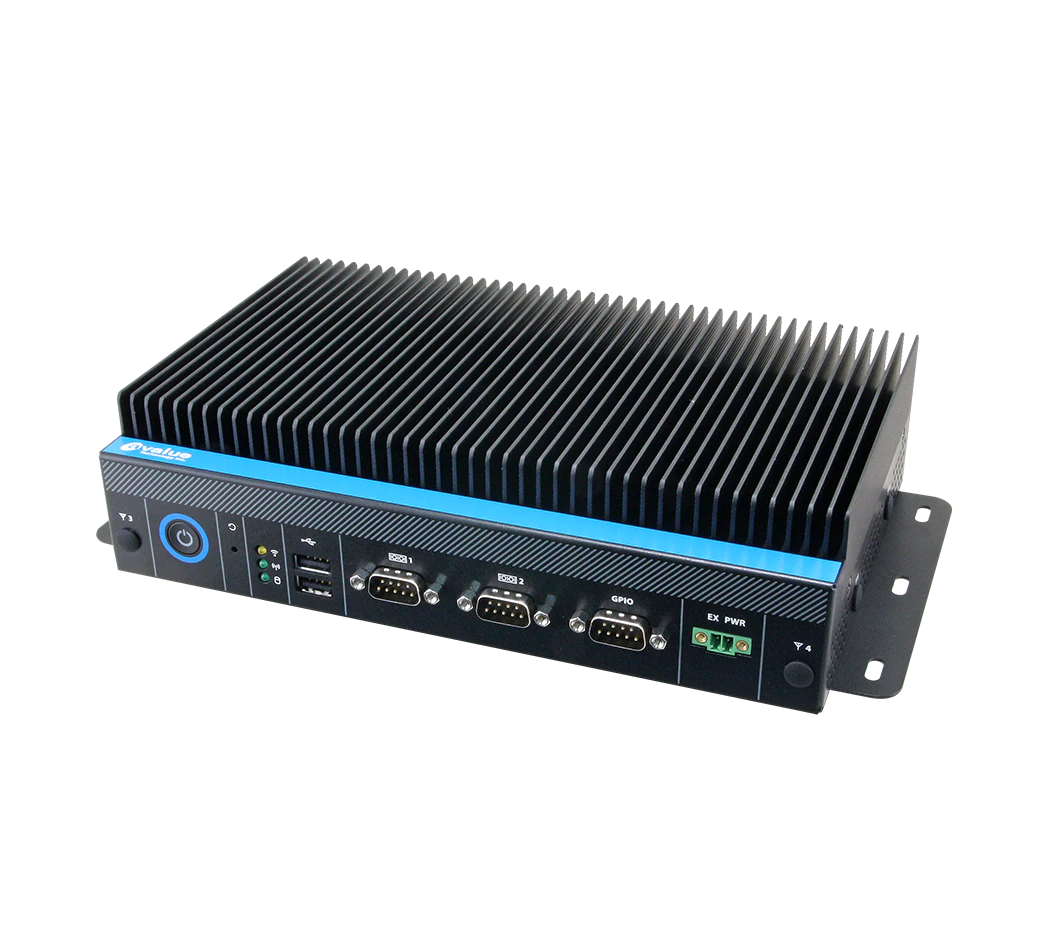
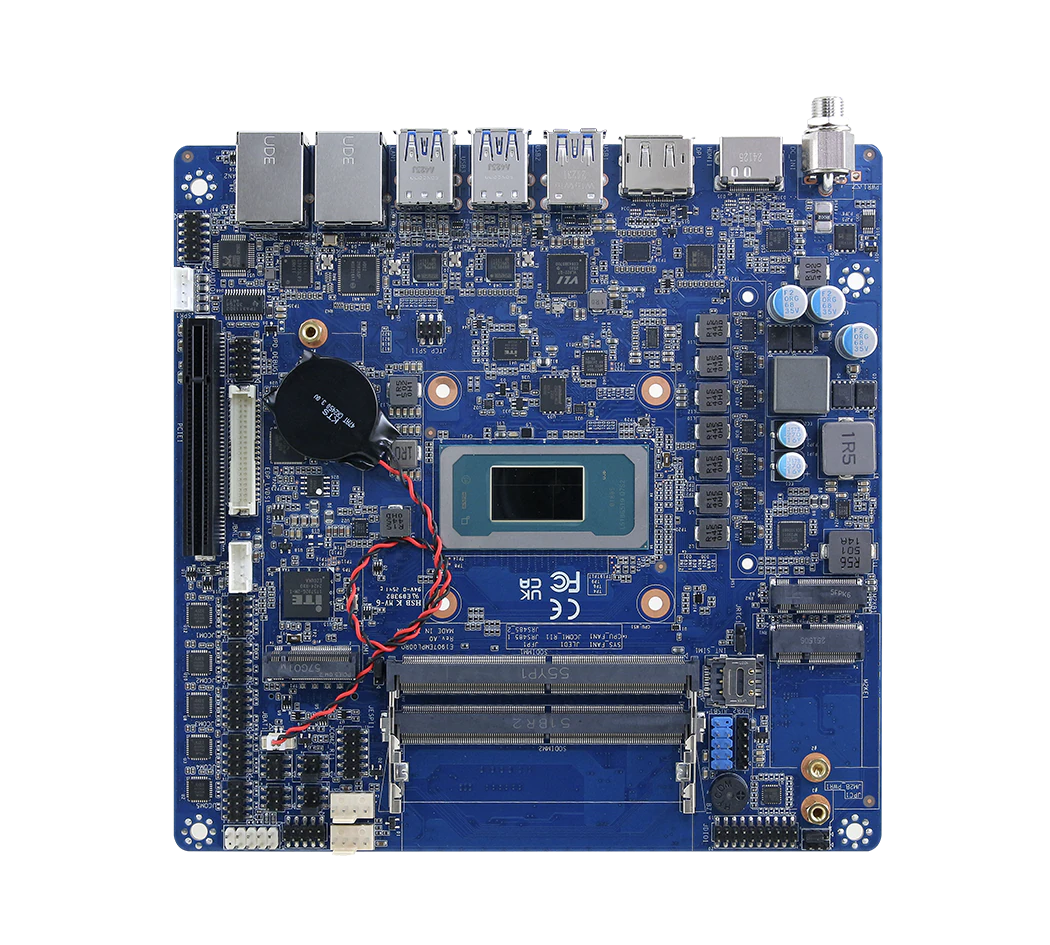
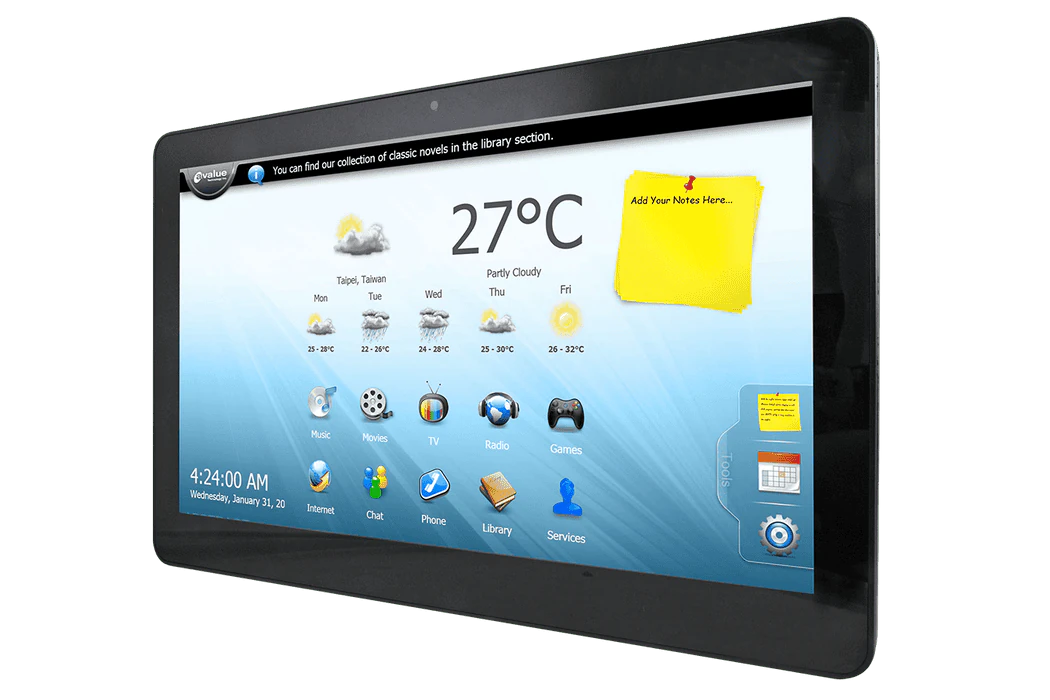
Concrètement : un ou quelques flux caméra continus, détection de défauts, contrôle de présence, portes qualité, fonctionnant toute l'équipe dans une enveloppe thermique sans ventilateur. Dans notre catalogue, c'est la classe Core Ultra : le Box PC EMS-ARH, le Panel PC APC-2146 et la carte EMX-PTLP embarquent tous des NPU intégrés, et côté ARM, l'ACP-3588 amène les 6 TOPS du RK3588 au prix d'un ordinateur monocarte (SBC) sans ventilateur.
Quand avez-vous besoin d'un GPU ?
Lorsque le nombre de flux ou la taille du modèle dépasse les moteurs à fonction figée. La gamme embarquée NVIDIA Jetson Orin illustre le plafond : jusqu'à 275 TOPS pour 15 à 60 W sur AGX Orin, 157 TOPS sur Orin NX, 67 TOPS sur Orin Nano (NVIDIA, officiel). Les GPU PCIe dédiés vont encore plus loin, pour plusieurs centaines de watts.
Les GPU justifient ce budget énergétique dans trois situations : de nombreux flux simultanés alimentant un même système, par exemple un poste AOI surveillant une douzaine de caméras ; des modèles volumineux ou non quantifiés, réseaux de segmentation, charges de type LLM ; et l'itération rapide, où la maturité logicielle de CUDA raccourcit les développements. Le schéma matériel correspondant est une station de travail dotée de véritables emplacements PCIe et d'un refroidissement adapté : dans notre gamme, c'est la classe HPS-ERSUTA, spécifiée avec le GPU dont votre framework a besoin.
Comment décider concrètement ?
Raisonnez à rebours depuis la ligne, et non en partant des TOPS. Comptez les flux (une caméra ou douze), énoncez le temps de cycle (une décision toutes les 50 ms ou toutes les 5 s), dimensionnez le modèle (un classifieur quantifié ou un réseau de segmentation) et fixez le budget de boîtier (armoire scellée sans ventilateur ou baie ventilée). Ensuite : service léger sur un seul flux, CPU. Vision continue sur un à quelques flux dans un boîtier sans ventilateur, NPU. Beaucoup de flux ou des modèles lourds avec refroidissement disponible, GPU.
Et considérez les TOPS comme un chiffre d'entrée, pas comme un verdict. Les valeurs annoncées mélangent les précisions (INT8 contre FP16 double à peu près le compte), supposent une utilisation idéale et ne disent rien du comportement mémoire de votre modèle. Le test honnête, c'est votre modèle, quantifié tel que vous le livrerez, sur le matériel candidat. Ce dimensionnement par le banc d'essai d'abord est exactement notre approche dans notre guide d'achat des serveurs edge IA, et si la question périphérie ou cloud reste ouverte, commencez par notre comparaison edge contre cloud. Donnez-nous votre nombre de caméras et votre temps de cycle, et nous présélectionnerons du matériel que vous pourrez mettre à l'épreuve.
Questions fréquentes
TSL Automation Solutions
Responsable marketing, TSL Automation Solutions
Sanjana couvre les tendances de l'automatisation industrielle, les lancements de produits et les analyses technologiques pour TSL Automation Solutions, distributeur basé à Mumbai d'IHM, de Panel PC et de systèmes informatiques embarqués au service des industriels en Inde et dans le monde.
Besoin d'aide pour choisir le bon produit ?
Notre équipe à Mumbai peut vous recommander l'IHM, le Panel PC ou le système embarqué adapté à votre application.
Contacter TSL AutomationProduits associés
Articles associés

IA embarquée ou IA cloud dans l'industrie : latence, bande passante et coûts réels
17 août 2026

Flambée des prix de la mémoire en 2026 : ce que la hausse de la DRAM change pour les acheteurs
17 août 2026
DDR5 ou DDR4 en informatique industrielle : avez-vous vraiment besoin de DDR5 ?
20 mai 2026